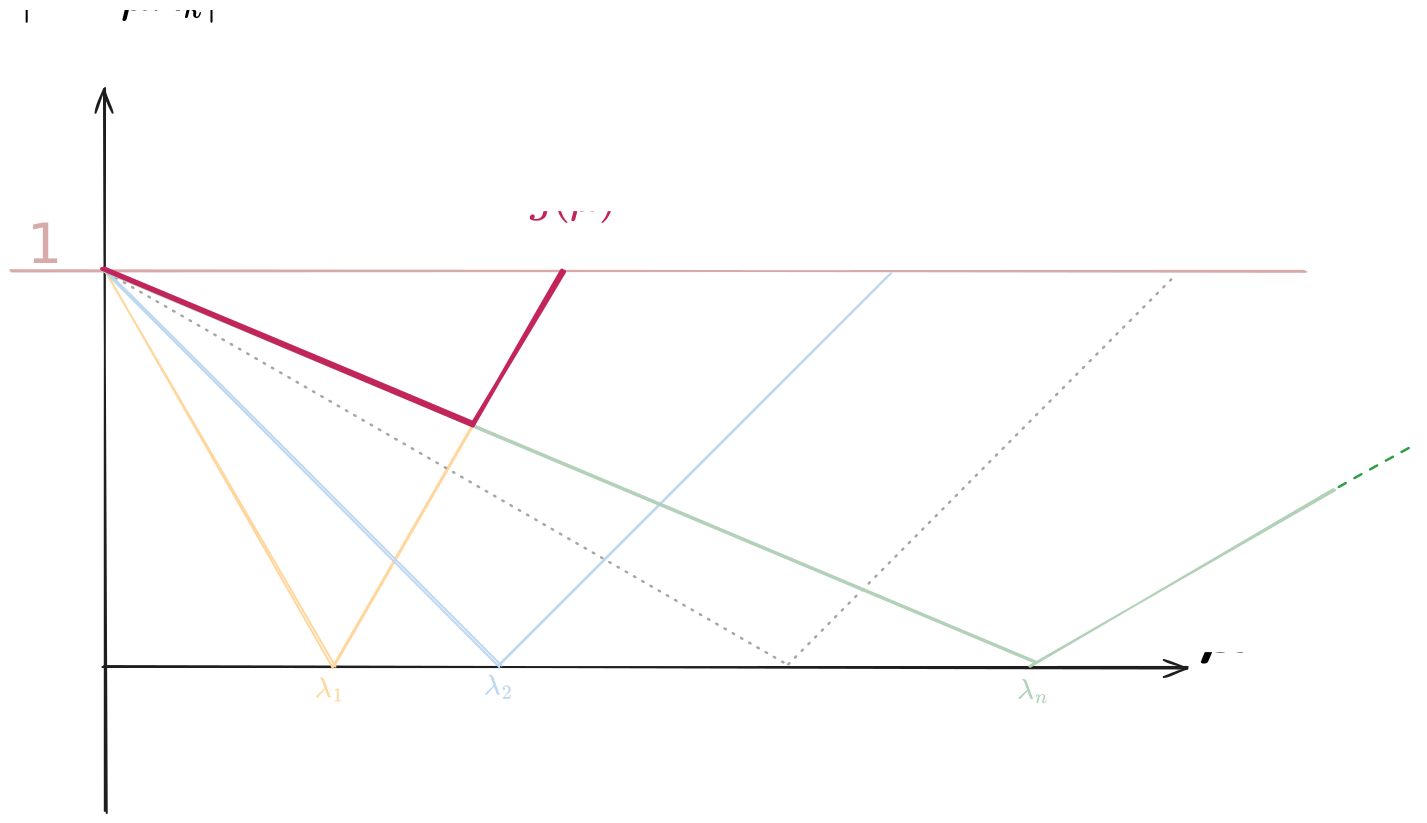הבעיות שראינו עד כה, פירוק LU, פירוק SVD וכדומה, נהדרות כאשר אנו מדברים על גדלים סופיים וקטנים של מטריצות, אבל מה עם מטריצות בגודל 1000×1000 או בגדלים השואפים ל-∞? פה נדרש משהו חזק יותר.
בפרק זה נראה דרך לצמצם בעיות גדולות לבעיות קטנות יותר והכל דרך המשוואה uk+1=Auk אשר מייד נראה כמה היא חזקה.
הרעיון בעצם בתהליכים איטרטיביים הוא לקחת איזושהי בעיה ולהתחיל מפתרון שרירותי מסויים ואז לדייק אותו קצת ואז לדייק אותו עוד קצת ואז עוד קצת וחוזר חלילה עד אשר אנו מגיעים לפתרון המדוייק.
תהליכים איטרטיביים
נסתכל על מערכת דינמית פשוטה המתחילה בוקטור u0 ומטריצה ריבועית בגודל n×n בשם T. המערכת שלנו הינה:
uk=Tuk−1=T(Tuk−2)=T(T(Tuk−3))=⋯=Tku0
נשים לב כי Tku0 נותן לנו את uk.
נניח כעת כי T לכסינה, כלומר יש לה n ו"ע המהווים בסיס ולכן ניתן לכתוב כי T=VAV−1. נציב את פירוק זה למערכת:
נסתכל על סדרת פיבונצי המוגדרת: fk+2=fk+1+fk,f1=f0=1.
נגדיר: uk=(fkfk+1)=(0111)(fk−1fk)=Tuk−1. לכן, הפעם T=(0111),u0=(11).
נמצא את הע"ע: λ1=1.618,λ2=−0.618 ואז v1=(−λ21)∧v2=(−λ11) ואז נקבל:
הערך העצמי המקסימלי, המיוצג ע"י הרדיוס הספקטרלי, קטן מ-1 ולכן בחזקה השואפת ל-∞ הוא מתכנס ל-0. ∎
הערה
אנו חייבים לדרוש שכל הע"ע יהיו קטנים מ-1 כדי שזה יעבוד.
ניתן להגיד כי מתקיים בערך: uk=VAkx0=j=1∑nx0(j)λjkvj≈x0(1)λ1kv1.
בהמשך להנ"ל, אם נקבע כי x0(1)=0 אזי נחשוב כי השפעתו של הע"ע הגדול תנוטרל, אך אין זה כך. שגיאות נומריות מזעריות יגרמו לע"ע זה לקחת שליטה בסופו של דבר על מלוא התהליך.
עד כה ראינו כי אם המערכת uk=Tku0 פועלת ע"י מטריצה T לכסינה, הרדיוס הספקטרלי שלה p{T} יקבע אם תחול התכנסות לאפס.
בדיקה זו היא מורכבת מאוד ומוגבלת למטריצות לכסינות בלבד, נרצה לראות משהו אחר, אשר יעבוד גם עבור מטריצות לא לכסינות. משהו שייצג איזשהו מרחק של מטריצות מהאפס. זה נשמע כמו נורמה, ולזה באמת יקראו נורמות של מטריצות.
אנו מכירים את הקונספט של נורמה בהקשר של קביעת אורך לוקטור ואנו נכליל אותה למטריצות.
עד כה ראינו נורמה אחת למטריצות והיא נורמת פורביניוס אשר הינה מאוד פשטנית ומתייחסת למטריצה כווקטור שקופל.
בפרק זה נראה נורמות טובות יותר עבור מטריצות אשר יעזרו לנו בקביעת ההתכנסות למערכת.
משפט
בהינתן כל שתי נורמות המוגדרות לוקטורים במימד n:
∥⋅∥B,∥⋅∥A
המקיימות את האקסיומות הנדרשות, קיימים בהכרח שני קבועים 0<c1<c2<∞ כך שמתקיים:
∀v∈Fn:c1∥v∥A≤∥v∥B≤c2∥v∥A
מסקנה
∥vk∥Ak→∞0⟺∥vk∥Bk→∞0
הגדרה 3 (נורמה אופרטיבית(מושרית))
בהינתן הנורמה הוקטורית ∥⋅∥A לוקטורים ממימד n.
נגדיר את הנורמה האופרטיבית של המטריצה T בגודל n×n ע"י
קיבלנו פה חסם עליון לנורמה. מתי זה יהיה שווה? אם לכל T שייבחר, נוכל למצוא וקטור v∗ שיגרום לשוויון, בהכרח ביטוי זה הוא הנורמה: ∥v∗∥∞∥Tv∗∥∞=kmax{j=1∑n∣tkj∣}.
בואו נשתכנע(כי הוכחה זה מעל רמת הקורס הזה) שקיים וקטור שכזה:
נניח כי ביטוי משיג את שיאו עבור השורה הראשונה k=1, אזי נמצא וקטור v∗ מנורמל שאיברים הם ±1 כשהסימנים תואמים את סימני איברי השורה. אזי נקבל: Tv=t11⋮tn1t12⋮tn2t13⋮tn3⋯⋯t1n⋮tnm±1⋮±1=j=1∑n∣t1j∣⋮
ולכן:
מסקנה
∥∣T∣∥∞=kmax{j=1∑n∣tkj∣}
חישוב הנורמה ∥∣T∣∥1 נעשה בדרך כמעט אחד לאחד כמו נורמת ה-∞ ולכן נדלג על הדוגמה.
נראה כעת מה קורה עם ∥∣T∣∥2:
נסתכל כעת על גישאה אחרת לאומדן יציבותה של המטריצה T המציעה דרך למקם את הע"ע במישור המרוכב.
משפט (גרשגורן)
למטריצה T ריבועית כלשהי בגודל n×n נגדיר n דסקאות כך:
Dk=⎩⎨⎧z∈C∣z−tkk∣≤j=k∑∣tjk∣⎭⎬⎫
אזי, כל הע"ע של T מוכלים באיחוד של הדיסקאות הללו.
הערה
כל דסקה נוצרת משורה אחת ב-T כשמרכזה הוא איבר האלכסון ורדיוסה הוא סכום יתר האיברים בערך מוחלט.
90% מהוכחה:
נניח כי λ הוא ע"ע של T עם ו"ע x ולכן Tx=λx.
נניח כי האיבר הדומיננטי(הגדול בערכו המוחלט) ב-x הוא x1.
נארגן מחדש את המשוואה הראשונה במערכת Tx=λx:
הע"ע של T הינם: λ1=4.74,λ2=1.18,λ3=2.04+0.79i,λ4=2.04−0.79i.
נשים לב כי הם באמת בתוך הלולאות.
דוגמה
עבור המטריצה מהדוגמה הקודמת, מה צריך להיות a על מנת להבטיח את יציבותה של המטריצה aT?
a<∣λ1∣1=4.741
ע"פ משפט גרשגורן, ניכר כי הנקודה הרחוקה ביותר מהראשית היא 5.6 ולכן, אם אנו לא יודעים את הע"ע נוכל לדרוש משהו חלש יותר: a<5.61
הגדרה 4 (מטריצה דומיננטית באלכסון)
מטריצה T נקראת דומיננטית באלכסון אם מתקיים כי כל איבר אלכסון גדול ממש(בערכו המוחלט) מסכום יתר האיברים בשורתו.
כלומר,
∀1≤k≤n:∣tkk∣>j=k∑∣tkj∣
מסקנה
מטריצה עבורה כל דסקאות גרשגורן שלה לא מכילות את הראשית תהיה דומיננטית באלכסון.
מסקנה (מהמסקנה)
מטריצה דומיננטית באלכסון בהכרח הפיכה כי אפס לא יכול להיות ע"ע שלה.
פתרון בעיות באמצעות אלגוריתמים איטרטיביים
פתרון מערכת משוואות Ax=b
נקח A ריבועית והפיכה ונרצה לפתור את מערכת המשוואות Ax=b.
הבעיה שלנו היא ש-A ענקית. כלומר, n≫1000 ולכן LU,QR או SVD לא יעבדו שכן לוקח להם יותר מידי זמן.
בנוסף, שיטות הפתרון הנ"ל מובילות לפתרון מדוייק ואנו סבבה עם להתפשר על פתרון "מספיק קרוב" שיושג עם מעט חישובים.
Proposition
בחר פתרון אתחול מסויים x0 (למשל 0)
עדכן פתרון זה באופן איטרטיבי ע"י הנוסחה xk+1=Txk+c.
כעת נגלה מהן T,c ולמה זה בכלל יעבוד?
מחד, בהנחה שחלה התכנסות, עבור k→∞ נגיע לפתרון x∗ המקיים x∗=Tx∗+c, מאידך, אנו רוצים שפתרון זה יהיה x∗=A−1b.
לכן נקבל את הקשר:
(I−T)A−1b=c
דוגמה
נבחר c=b וכמו כן T=I−A.
ברור שהבחירה מקיימת את המשוואה ולכן xk+1=Txk+c=(I−A)xk+b.
אם אלגוריתם זה יתכנס, הוא ישאף לפתרון הנכון.
Proposition (לבחירה שיטתית)
נעביר את Ax אגף לקבלת 0=−Ax+b. נוסיף x לשני האגפים כעת: x=(I−A)x+b. נקבל אם כן:
xk+1=(I−A)xk+b
כעת אם האלגוריתם יתכנס הוא יגיע לפתרון הנכון.
גישה זו קוריה אסטרטגיית נקודת השבת המוכרת גם בהקשר של מציאת פתרון למערכת משוואות לא ליניאריות.
כעת נרצה לדעת מה צריך לדרוש כדי שהמשוואה תתכנס:
אם התהליך יתכנס נקבל x∗=Tx∗+c
נחסר את משוואה זו ונקבל: (xk+1−x∗)=T(xk−x∗)
נסמן ek=xk−x∗ ואז ek+1=Tek.
מסקנה
אם T יציבה, אזי התהליך יתכנס.
אלגוריתם ג'קובי
תהי A מטריצה.
את A ניתן תמיד לפצל לסכום מהתצורה A=L+D+U כאשר:
זהו אלגוריתם גאוס-איידל (באנגלית כותבים את השמות שלהם: Gauss−Seidel)
לכאורה עלינו להפוך כאן מטריצה, אך זה לא הסיפור - אנו בעצם יכולים לפתור את מערכת המשוואות (L+D)xk+1=b−Uxk מה שיעשה באמצעות החלפה קדמית, כאשר אנו מעדכנים את וקטור הפתרון איבר-איבר בצורה סדרתית.
נשים לב להבדל משמעותי מהאלגוריתם הקודם שכן פה, בהינתן xk באיטרציה ה-k, המשוואה פועלת הפעם כך:
הקפא את כל איברי הפתרון למעט ה-j ועדכן אותו.
נשים לב שבגלל שאנו עושים את זה איבר איבר, חלק מהפתרון כבר עודכן והערכים החדשים נלקחים בחשבון.
משפט (אלגוריתם Gauss−Seidel)
xk+1=(L+D)−1(b−Uxk)
מתכנס לפתרון מערכת משוואות Ax=b אם A מטריצה סימטרית וחיובית מוגדרת, או דומיננטית באלכסון.
ההוכחה מורכבת מעט ולכן לא בקורס הזה.
הערה
ישנו אלגוריתם נוסף הנקרא SOR והוא
xk+1=(L+αD)−1(b−((1−α)D+U)xk)
עבור α=1 אלגוריתם זה מתלכד עם גאוס-איידל.
בדרך כלל נבחר את α עם ערך גדול מ-1 על מנת לסחוט התכנסות מהירה יותר.
שימוש באלגוריתם למטריצות כלליות
אם היינו רוצים לפתור מערכת משוואות עם מטריצה כללית A, אז על מנת להפוך אותה לחיובית מוגדרת נכפיל ב-At ונקבל:
AtAx=Atb
ואת זה נשים באלגוריתם שלנו.
נשים לב כי זוהי בעצם המשוואה הנורמלית שבאה מריבועים פחותים, זה בעצם שולח אותנו לפתור בעיית ריבועים פחותים במקום הבעיה המקורית.
פתרון בעיות ריבועים פחותים
נסתכל על בעית ריבועים פחותים כללית כאשר אנו מניחים שלה יש פתרון יחיד:
xmin21∥Ax−b∥22=xmin21xtKx−xtf+c
אנו יודעים כי הפתרון לבעיה זו עד כה היה:
AtAx=Atb∨Kx=f
אנו טכנית יכולים לחשב את המטריצה K=AtA ואז לבצע את גאוס איידל אך זה לא פתרון טוב שכן הכפלת מטריצות בגדלים העצומים הללו היא פעולה שלוקחת מלאאאאאא זמן.
אלגוריתם השיפוע המירבי
אנו הולכים לראות כעת שני דרכים לביצוע האלגוריתם הזה אשר יפתרו לנו באמצעות שיטות איטרטיביות בעיות ריבועים פחותים.
שיטה 1
הגישה הראשונה תפעל ברוח הגישה של נקודת השבת שראינו ממקודם.
נשים לב כי נדרש כי T שלנו תהיה יציבה, כלומר, ש-I−μAtA תהיה יציבה על מנת שהאלגוריתם יתכנס.
נשים לב בנוסף כי במטריצה הזו יש לנו פרמטר μ שנוכל לשחק איתו ובכך אולי להשיג מטריצות יציבות.
שיטה 2
נזכר כי גרדיאנט של פונקציה מצביע בכיוון העליה המירבית, כלומר, השיפוע הגדול ביותר, לכן, אם נלך בכיוון ההפוך נגיע לירידה המירבית, שהיא מה שאנו רוצים לבעיית min.
ראינו בפרק על ריבועים פחותים מהיא הנגזרת של הבעיה:
f(x)=21∥Ax−b∥22⟹∇f(x)=At(Ax−b)
בכל איטרציה, כשאנו בנקודה xk, נחשב את הגרדיאנט של f(x) בנקודה זו, ונלך בכיוון ההפוך לכיוונו כך:
xk+1=xk−μAt(Axk−b)
המקדם μ נחוץ כי אנו צריכים לקבוע איזו כברת דרך לעשות בכיוון הנבחר.
מוצאים את המקדם
בשתי השיטות הגענו בסוף לאותה המשוואה בעלת המקדם μ. נרצה למצוא אותו כך שהמטריצה T=I−μAtA תהיה יציבה.
נשים לב כי AtA חיובית מוגדרת ולכן יש לה n ע"ע ממשיים וחיוביים.
נקח λ שהינו ע"ע של AtA עם ו"ע התואם לו v ונקבל:
עבור הע"ע של AtA המסומנים λ1≥λ2≥⋯≥λn−1≥λn>0 נקבל כי לכל 1≤k≤n הערך (1−μλk) הוא ע"ע של T=I−μAtA.
מסקנה (מהמסקנה)
כדי ש-T תהיה יציבה, עלינו לדרוש:
g(μ)=1≤k≤nmax∣1−μλk∣<1
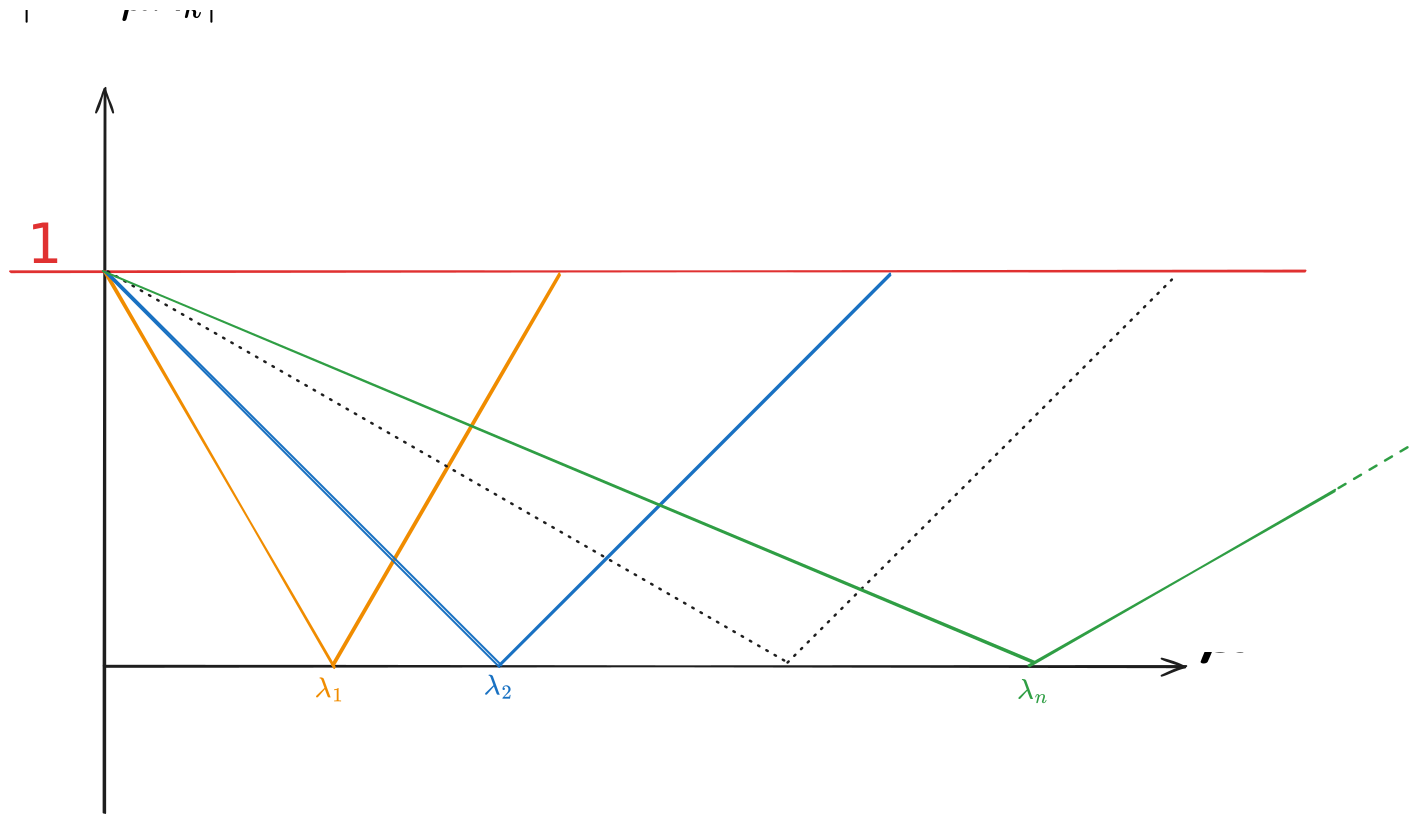
מה שראינו פה זה פונקציה, לכן, נוכל לחקור אותה ולהגיע לפתרון. נסתכל על גרף הפונקציה:
כעת, נוכל לקחת את המקסימום של כל חלק וזו תהיה g(μ) שלנו:
כעת, ברור כי על מנת להבטיח התכנסות אנו חייבים לדרוש כי:
0<μ<λ12
כעת, לאחר שהגדרנו גבולות ברורים למקדם, אנו נרצה למצוא את המקדם האופטימלי, זה שיביא לנו את ההתכנסות הכי מהירה ⟸ הוא נקודת המינימום של g(μ) שראינו בגרף הנ"ל.
על מנת למצוא את הנקודה הזו, נמצא את נקודת החיתוך בין הגרפים הירוק והצהוב:
1−μλn=μλ1−12=μ(λ1+λn)
הבעיה פה היא שאנו צריכים לדעת שני ערכים עצמיים, אבל בינתיים אין לנו דרך להתחמק מזה.
נציב כעת את הערך שקיבלנו על מנת למצוא את גובה ההתכנסות:
אנו רואים כי אשר מפר המצב של AtA גבוה, ההתכנסות תהיה איטית.
עוד משחקים על המקדם
עד כה הנחנו כי עלינו לבחור μ קבוע לכל אורכו של התהליך. מה אם נשנה אותו מאיטרציה לאיטרציה?
נבצע איזשהו אלגוריתם לו נקרא חיפוש על ישר אשר יביא לנו בכל איטרציה את הערך האופטימלי עבור μ שיסחט את המירב מהאיטרציה במובן של הורדת גובהה של הפונקציה באופן מירבי.
נסתכל על השיטה:
נניח כי עתה סיימנו את האיטרציה ה-k ובידינו הפתרון הזמני xk.
באיטרציה הבאה אנו נפעל לפי העדכון הבא: xk+1=xk−μAt(Axk−b)=xk−μek
נבחר את הערך של μ כך שגובה הפונקציה יהיה המינימלי האפשרי כך: f(xk+1)=21Axk+1−b22=21∥Axk−μAek−b∥22=f(μ)
נשים לב כי הנעלם היחיד בפונקציה הזו הוא μ ובנוסף, זוהי רק פרבולה חד מימדית ("חזרתם לכיתה ט'" - מיקי אלעד)
נגזור את הביטוי שקיבלנו באמצעות גזירה מטריצית וקטורית ונקבל: dμdf(μ)=−ektAt(Axk−μAek−b)=0
נשים לב כי מתקיים: μektAtAek=ektAt(Axk−b)=ektek
ולכן נקבל כי: μ=ektAtAekektek=∥Aek∥22∥ek∥22
וזה האלגוריתם המלא:
Algorithm 3 Normalized Steepest Descent (NSD)
Require: Matrix A, Target vector b, Initial guess vector x0
זה לא מפתיע שכן ek הוא וקטור השגיאה של פתרון המשוואה הנורמלית, וראינו כבר כי השגיאה צפויה להתנהג לפי ek+1=Tek.
נכפיל משוואה זו משמאל ב-ekt ונקבל:
מה שקורה פה בעצם הוא שהזווית בין כל שגיאה של כל איטריצה שואפת להיות 90° - האלגוריתם הזה מזגזג בצורה מטורפת.
זה לא הכי טוב, אבל זה האלגוריתם ויש דרכים להתמודד עם זה.
הפתרון הנפוץ ביותר הוא לסדר מעט את נוסחת האיטרציה לקבלת נוסחה מורכבת מעט יותר אשר איתה קצב ההתכנסות יכול להשתפר פלאים:
xk+1=xk−μkek+θkxk−1
פתרון בעיות ערכים עצמיים ווקטורים עצמיים
האתגר האחרון לחלק זה בקורס הוא למצוא ע"ע וו"ע למטריצות בגדלים עצומים כגון מליון על מליון.
האלגוריתם שנמצא כבר הופיע בחלקו בקורס זה ממקודם והוא נקרא שיטת החזקה ועוד מעט נראה אותו במלואו. הבהרה: אם המטריצה גדולה כל כך, ברור שאנו לא נחפש את מלוא הו"ע כי כמותם עצומה, אלא נתמקד בחלקם באיזשהו אופן.
נזכר מתחילת הפרק כי ראינו שעבור מטריצה T הניתנת ללכסון נקבל את סדרת הוקטורים הבאה:
uk=VAkx0=j=1∑nx0(j)⋅λjkvj
נניח כי הע"ע מסודרים בסדר יורד לפי ערכם המוחלט ובנוסף נניח כי ∣λ1∣>∣λ2∣≥∣λ3∣≥⋯≥∣λn−1∣≥∣λn∣. כלומר, שני הע"ע אשר בערך מוחלט הם הגדולים ביותר, אינם שווים.
כךף נוכל להגיד את הדבר הבא כאשר k גדול דיו:
משמעות ביטוי זה היא שהפעלה ארוכה של המערכת הדינמית תוביל לו"ע המתייחס לע"ע הגדול ביותר בערך מוחלט של T.
נניח שאכן קיבלנו וקטור זה, נוכל ממנו לקבל את ע"ע התואם לו כך:
יש אלגוריתם, אז הכל אחלה - וייייייייייייייייייייייי
אלא, שיש בעיה אחת, הוא לא עובד!!! זאת מפאת העובדה שהמקדם λ1k או צולל לאפס או תופח ל-∞ ומגיעים מהר מאוד לבעיות נומריות קשות.
הפתרון לבעיה זו היא לנרמל לאחר כל איטריצה והאלגוריתם החדש והמשופר נראה כך:
שיטת החזקה מובטחת להגיע לוקטור העצמי המתייחס לע"ע הגדול ביותר אם מתקימים שני התנאים הבאים:
ע"ע זה מבודד, כלומר, ∣λ1∣>∣λ2∣.
וקטור האיתחול אינו מנוון את הו"ע המבוקש:
uk=VAkx0=j=1∑nx0(j)⋅λjkvj⟹x0(1)=0
הערה על ההוכחה שאין: אם נכניס הנחה נוספת של היות T לכסינה, כבר הוכחנו זאת בנכתב למעלה, אך מסתבר שדרישת הלכסינות אינה דרושה ואת החלק הזה לא נוכיח בקורס.
מסקנה
קרבה גדולה מידי בין הע"ע העליונים תביא להתכנסות איטית.
גרסאות לאלגוריתם
גרסת ההיפוך
אם נרצה לכוון לע"ע הקטנים ביותר נרצה להפוך את ההתכנסות ולכן:
uk=T−1uk−1
כמובן שאנו לא הופכים מטריצות, אלא אנו פותרים מערכת משוואות.
גרסת ההזזה
אם משוואת העדכון תשתנה כך:
uk=(T−αI)uk−1
אזי האלגוריתם יתמקד בע"ע של T−αI הרחוק ביותר מהראשית.
מציאת כל הע"ע והו"ע
אם נרצה למצוא מספר ע"ע וו"ע לא נוכל להריץ את התהליך מספר פעמים, שכן כל התוצאות יהיו הוקטור הראשון.
נניח מעתה כי המטריצה T סימטרית ולכן ידוע כי וקטוריה העצמיים אמורים להיות אורתוגונליים.
לכן, נוכל להריץ את התהליך במקביל ולבצע אורתוגונליזציה בין הוקטורים אחרי כל איטרציה, כצעד שמחליף את הנרמול הנפרד לוקטורים.
גישה זו עובדת יפה אך רק למטריצות סימטריות. גרסה למטריצות שאינן סימטריות אנו נראה בתרגול :)
Algorithm 5 Iterative Solution for Eigenvalue Problems (Subspace Iteration)
Require: Symmetric matrix T of size n×n, Number of desired eigenvectors J