שפת התכנות נבנתה מעל והיא מוסיפה מגוון רב של תכונות מתקדמות כדי שיהיה לנו קל יותר לתכנת עם דגש על תכנות מונחה עצמים, תכנות גנרי וניהול שגיאות.
ב- נהוג לכתוב בתצורה שונה מעט ואת זאת נראה עוד מעט.
המהדר
אנו נשתמש במהדר כדי להדר קוד אשר ימצא בקבצי מקור בעלי סיומת או (גדולה).
פקודת הקימפול תראה כך:
$ g++ -std=c++17 -Wall -Werror -pedantic-errors main.cpp -o HelloWorld
תוכנית ב-
כפי שנאמר מקודם ישנם כמה שינויים בתכנות ב-. נראה כמה מהם כעת.
השינוי הראשון שהוא שקבצי ה- הסטנדרטיים של הם ללא סיומת. למשל, .
בואו נראה את התוכנית:
#include <iostream>
using namespace std;

int main()
{
	cout << "Hello world" << endl;
	return 0;
}
בשורה הראשונה אנו מכניסים את שמאפשרת קלט ופלט ונדבר עליה יותר עוד שניה.
בשורה הראשונה אנו עושים משהו משונה שעליו נלמד בהמשך בהרצאות ובתרגולים. אבל בפשטות, אנו פותחים את האופציה לשימוש בפקודות שנמצאות תחת השם ללא ציון מפורש של .
לאחר מכן יש לנו את הפונקציה הראשית שלנו שזהה לזו שב-.
הפלט שלנו נראה מאוד מוזר ולכן נדבר עליו עכשיו.
קלט ולפלט
קלט ופלט מבוצעים ב- באמצעות כאשר:
- קליטה מבוצעת ע"י .
- פליטה מבוצעת ע"י .
קריאה וכתיבה לסטרימים מתבצעות באמצעות אופרטור קלט ואופרטורי פלט .
הסטרים משמש לקריאה מהקלט הסטנדרטי והסטרים משמש לכתיבה לפלט הסטנדרטי.
ניתן להדפיס תו ירידת שורה באמצעות הקבוע .
בנוסף, ניתן לשרש מספר הדפסות באותה הפקודה.
int i;
double d;
char c[100];

...

cin >> i; // reading input as integer
cin >> d; // reading input as double
cin >> c; // reading input as c string (SHOULD BE AVOIDED!)

...

cout << "this is i: " << i << endl << "this is d: " << d << endl << "this is c: " << c << endl;
קליטה ברציפות
ניתן לבדוק האם סטרים קלט הסתיים באמצעות הפעולה(בעצם שיטה(שזה )) כך:
while (!cin.eof())
{
	// read some input and do stuff...
}
הסטרים מסתיים כאשר הוא מקבל את התו המיוחד המייצג סיום.
- כאשר מפנים קלט מקובץ - תו זה מועבר אוטומטית בסוף הקובץ
- כאשר כותבים קלט בטרמינל - ניתן להעביר את התו במפורש באמעות .
מחרוזות
ב- מוגדר עבורינו הטיפוס ב- המייצג מחרוזת.
על מנת להשתמש בו נדרש להכניס אותו לתוכנית שלנו כך:
#include <string>
using std::string
את זה נכתוב בראש הקובץ.
השימוש ב- מסיר את הצורך בניהול מפורש של הזכרון.
נשתמש ב- כך:
int main()
{
	string s = "Learning how to use string";
	string s2 = "spring semester";
	string s3 = s + " " + s2;
	s3[s3.size() - 1] = "!";
	cout << s3 << endl;
	return 0;
}
פעולות על מחרוזות
- שרשור מחרוזות - באמצעות אופרטור החיבור
- העתקת מחרוזות - באמצעות אופרטור ההשמה
- גישה לתו במחרוזת - באמצעות אופרטור הסוגריים המרובעים
- אורך המחרוזת - מוחזר מהמתודה
- השוואה לקסיקוגרפית של מחרוזות - בעזרת אופרטורי ההשוואה ()
קריאת וקליטת מחרוזות
קריאה
ניתן לקרוא מחרוזות מהקלט עד "התו הלבן"(רווח/טאב/ירידת שורה) באמצעות אופרטור הקלט .
אם נרצה לקרוא שורה שלמה כולל רווחים, נוכל לבצע זאת באמצעות הפקודה כך:
string s;
cin >> s; // reads a single word
getline(cin, s); // read until the end of the line
כתבו את התוכנית - כל שורת קלט שהתוכנית תקבל תודפס לפלט הסטנדרטי.
#include <iostream>
#include <string>

using namespace std;

int main()
{
	string s;
	while (!cin.eof())
	{
		getline(cin, s);
		cout << s << endl;
	}
	return 0;
}
מצביעים
במצביעים הכל נשאר אותו הדבר מ- (במצביעים רגילים בלבד) אך כן יש כמה שיפורים.
- במקום לכתוב אנו נשתמש בקבוע החדש .
וזהו - זה השיפור היחיד.
אם אתם לא זוכרים מצביעים אתם מוזמנים להתרען בקצת מבוא למדמח :)
העברת פרמטרים ל-
ראינו בפקודות ה- קבלה של ערכים בתוך שורת הפקודה. איך נעשה זאת עם תוכניות ?
נכתוב את הפעולה הראשית שלנו כך:
int main(int argc, char** argv)
במקרה זה יילקחו הערכים משורת ההרצה של התכנית ויושמו לתוך המשתנים שקיבלנו ע"י מערכת ההפעלה בתצורה הבאה:
- המשתנה יאותחל למספר הארגומנטים בשורת הפקודה(כולל שם הפקודה)
- המשתנה הוא מערך של מחרוזות כאשר התא ה- בו יכיל את הארגומנט ה- בשורת הפקודה. תא יכיל את שם התוכנה שהורצה.
- בנוסף, קיים איבר אחרון נוסף במערך המאותחל ל-.
עבור הרצת הפקודה:
echo Hello world
נקבל את הפרמטרים הבאים:
char** argv = {"./echo", "Hello", "world", NULL};
int argc = 3;
כתבו את התכנית המקבלת בשורת הפקודה מספר שרירותי של ארגומנטים ומדפיסה אותם לפלט הסטנדרטי.
הפתרון שלי:
#include <iostream>
#include <string>
using namespace std;

int main(int agrc, char** argv)
{
	for (int i = 1; i < argc; i++)
	{
		cout << argv[i] << " ";
	}
	cout << endl;
	return 0;
}
הפתרון שלהם:
#include <iostream>
#include <string>
using namespace std;

int main(int agrc, char** argv)
{
	for (int i = 1; i < argc; i++)
	{
		if (i != 1)
			cout << " ";

		cout << argv[i];
	}
	cout << endl;
	return 0;
}
הצעה נוספת לפתרון:
#include <iostream>
#include <string>
using namespace std;

int main(int agrc, char** argv)
{
	argv++;
	while (argv != NULL)
	{
		cout << *argv << " ";
		argv++;
	}
	cout << endl;
	return 0;
}
הקצאות זיכרון דינמיות
את המשתנים השונים בקוד ניתן לסווג לפי טווח השימוש בהם ואורך חייהם:
- משתנים מקומיים: משתנים פנימיים של פונקציות. נגישים רק בבלוג בו הם הוגדרו.
- משתנים גלובליים: משתנים אשר קיימים לכל אורך התוכנית וניתן לגשת אליהם מכל מקום.
- משתנים סטטיים של פונקציה: משתנים פנימיים של פונקציה אשר שומרים את ערכם בין הקריאות השונות לפונקציה. הם מוקצים בתחילת הריצה ומשוחררים בסיומה.
שימוש במשתנים אלו מקשה על הבנת ודיבוג הקוד:
- כדי להבין פונקציה המשתמשת במשתנה גלובלי יש להסתכל על כל קטע קוד שמשתמש בו - אפילו אם אין הוא קשור לפונקציה
- קשה לצפות את תוצאת הפונקציה כי היא אינה תלויה רק בפרמטרים שלה
- קשה לצפות השלכות על שינויים על ערך המשתנה
- בשימוש במשתנה סטטי של פונקציה - בשביל לצפות את תוצאת הפונקציה צריך לדעת מה קרה בהרצות הקודמות.
במתמ אסור להשתמש במשתנים גלובליים.
בהמשך התואר תראו קורסים מתקדמים בהם חובה או מומלץ להשתמש במשתנים כאלו.
עוד סוג של יצור הוא זיכרון שמוקצה דינמית שהוא זיכרון שזמן החיים שלו הוא בשליטת המתכנת. זיכרון זה מוקצה באיזור שקרוי ה-. (בניגוד למשתנים מקומיים שמוקצים על מחסנית הקריאות)
- זיכרון ה- גדול משמעותית ממחסנית הקריאות. מחסנית הקריאות איננה מתוכננת להכיל כמויות נתונים גדולות.
- במקרה של חוסר זכרון ב- התוכנית מקבלת על כך התראה מסודרת. לעומת זאת, לא ניתן להתאושש מכישלון הקצאה על המחסנית!
אנו נשתמש בזיכרון דינמי כאשר
- צריך לאחסן כמות גדולה של נתונים או להקצות זיכרון בגודל שאינו ידוע מראש
- יש צורך לשמור את הנתונים בזיכרון גם לאחר יציאה מהפונקציה.
הגישה לזיכרון הדינמי נעשית תמיד בעזרת מצביעים!
יצירת משתנה דינמי
הקצאות זיכרון דינמיות ב- מתבצעות ע"י האופרטור .
הקצאת ערך יחיד ואתחולו ניתן לבצע כך:
int* i1 = new int; // random value
int* i2 = ne int(7); // the new integer has the value 7
ניתן להקצות מערך ע"י:
int* array = new int[n];
האופרטור לעולם לא יחזיר .
כרגע נתעלם ממה שקורה כאשר ההקצאה נכשלת ונטפל בזה בהמשך הקורס.
שחרור משתנה דינמי
שחרור עצם שהקוצה ע"י מתבצע בעזרת כך:
delete ptr;
delete[] array; // delets a `new type[size_t]`
המצביע אותו משחררים חייב להצביע לתחילת גוש הזיכרון(לא ניתן למחוק מאמצע מערך)
לאחר שחרור הזיכרון אסור לגשת יותר לערכים בזיכרון ששוחרר.
אסור לשחרר את אותו זכרון יותר מפעם אחת.
במקרה ונשלח ל- לא מתבצע כלום.
לכן הקוד הזה:
if (ptr != nullptr)
	delete ptr;
יכול להיכתב גם כך:
delete ptr;
עדיף לטפל במקרי קצה בתוך הפונקציה(מונע מהמשתמש בה ליצור באגים ושכפולי קוד)
אסור לערבב את ו- עם ו-.
נוכל לכתוב את הקוד הבא ב-:
int* ptr = malloc(sizeof(int));
if (!ptr)
{
	// handle errors ...
}
*ptr = 5;
int* array = malloc(sizeof(*array)* *ptr);
if (!array)
{
	// handle errors ...
}
free(ptr);
free(array);
כך ב-:
int* ptr = new int(5);
int* array = new int[*ptr];

delete ptr;
delete[] array;
דליפות זיכרון
דליפות זיכרון מתרחשות כאשר שוכחים לשחרר זכרון שהוקצה.
דליפת זכרון אינה גורמת ישירות לשגיאות בהתנהגות התוכנה אך דליפת זכרון תגרום לצריכת זיכרון גדלה של התוכנה ככל שזמן ריצתה גדל ולהאטת התוכנה ומערכת ההפעלה כולה.
ישנם כלים בהם נשתמש על מנת לאתר דליפות זיכרון.
בעלות על זיכרון
הבעלים של זכרון הוא מי שאחראי לפנות אותו.
פונקציה אשר מקצה זכרון אחראית לפנותו, אלא אם היא מחזירה את הזכרון שהוקצה. במקרה זה הבעלות עוברת למי שקרא לפונקציה.
בקוד חייב להיות ברור מי אחרי על הפינוי של כל זיכרון שמוקצה - מידע זה חייב להיות מתועד היטב.
מבנים
ניתן להגדיר טיפוסים חדשים המהווים הרכבה של מספר טיפוסים קיימים בעזרת המילה השמורה כך:
struct <name>
{
	<typename 1> <field name 1>;
	<typename 2> <field name 2>;
	...
	<typename n> <field name n>;
} <declerations>;
הטיפוס החדש מורכב משדות כאשר לכל שדה יש שם וטיפוס השדה נקבע לפי הגדרת המבנה.
השדות של מבנה נשמרים בזיכרון ברצף.
ניתן להשתמש במערכים בעלי גודל קבוע כשדות וכל המערך נשמר במבנה
ניתן בנוסף להשתמש במצביעים כשדות ובמקרה הזה הערך המוצבע אינו חלק מהמבנה.
struct point
{
	double x;
	double y;
};

struct date
{
	int day;
	char month[4];
	int year;
};

struct person
{
	string name;
	struct date birth;
}
point p;
p.x = 3.0;
p.y = 2.0;
double distance = sqrt(p.x * p.x + p.y * p.y);
כאשר יש לנו מצביע למבנה ניתן להשתמש באופרטור מיוחד כך:
point* p = new point();
(*p).x = 3.0;
p->y = 2.5; // these two lines are the same

double distance = sqrt(p->x * p->y + p->y * p->y);
פעולות על מבנים
- ניתן לאתחל מבנים בעזרת התחביר:
date d = { 31, "NOV", 1970 }; - ניתן לבצע השמה בין מבנים מאותו הטיפוס:
date d1, d2; // ... d1 = d2; - מבנים מועברים ומוחזרים מפונקציות - כלומר, הם מועתקים.
- הפעולות האלו אינן מתאימות למבנים מסובכים יותר בעיקר בגלל מצביעים.
מבנים המכילים מצביעים אינם מתאימים בדרך כלל לביצוע השמות והעתקות. מסיבה זו וכדי למנוע העתקות כבדות ומיותרות של מבנים - בדרך כלל נשתמש במבנים באמצעות מצביעים.
רשימה מקושרת בעזרת מבנים
נסתכל על המבנה הבא:
struct Node
{
	int data;
	Node* next;
};
המבנה הזה נותן לנו לבנות רשימה שהיא מקושרת - אשר בה כל איבר מאחסן מצביע לבא אחריו כדי שנוכל לעבור על כולה.
ב- לא נוכל לבצע את ההגדרה ככה ונדרש לעשות:
typedef Node* nodeptr;
struct Node
{
	int data;
	nodeptr next;
};
למה? כי .
נסתכל על שימוש לדוגמה:
Node* node1 = new Node();
Node* node2 = new Node();

node1->data = 1;
node1->next = node2;
node2->data = 2;
node2->next = nullptr;
לאחר הפעולה הזו הזכרון יראה כך:
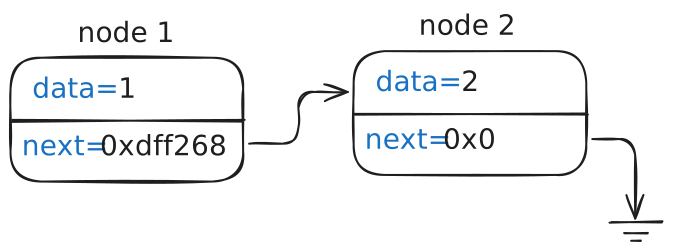
שרשרת של משתנים בזירון כאשר כל משתנה מצביע למשתנה הבא בשרשרת וסוף הרשימה מצביע ל-.
רשימה מקושרת הינה מבנה נתונים המאפשרת שיטה מסוימת לשמירת ערכים בזיכרון. (מערך הוא גם מבנה נתונים)
רשימה מקושרת מאפשרת:
- שמירה של מספר ערכים שאינו חסום ע"י קבוע
- הכנסה והוצאה של משתנים מאמצע הרשימה בקלות
- שרשור פיצול של רשימות בצורה נוחה
כתבו תכנית המקבלת רשימת מספרים מהמשתמש ומדפיסה אותם בסדר הפוך
אנחנו נצור רשימה מקושרת של מספרים וכל פעם שנקבל מספר חדש נוסיף אותו לתחילת הרשימה בקלות כך:
struct Node
{
	int data;
	Node* next;
};

Node* createNode(int d)
{
	Node* ptr = new Node();
	ptr->data = d;
	ptr->next = nullptr;
	return ptr;
}

void destroyList(Node* head)
{
	while(head)
	{
		Node* toDelete = head;
		head = head->next;
		delete toDelete;
	}
}

Node* insert(Node* head, int d)
{
	Node* newHead = createNode(d);
	newHead->next = head;
	return newHead;
}

int main()
{
	Node* head = nullptr;
	int input;

	while (!cin.eof())
	{
		cin >> input;
		head = insert(head, input);
	}

	for (Node* ptr = head; ptr != nullptr; ptr = ptr->next)
	{
		cout << ptr->data << endl;
	}

	destroyList(head);
	return 0;
}
- רשימה מקושרת יכול להיות גם דו-כיוונית. במקרה כזה לכל צומת יש שני מצביעים: ו-. (יתרונה של רשימה דו כיוונית היא בסיבוכיות בלבד.)
- נוח להוסיף איבר דמה לתחילת הרשימה כדי לצמצם את מקרי קצה שצריכים לטפל בהם בקוד.