קודים לגילוי שגיאות
מוטיבציה
כשמעבירים מידע בינארי על קו תקשורת עלולה לקרות תקלה, כך שהצד השני יבל אינפורמציה שונה מזו שנשלחה.
ישנם קודים לגילוי שגיאות ותיקונם.
הגדרות
קוד הוא אוסף של מילים מתוך אוסף כל המילים האפשריות.
עבור הקוד
במצב זה המילה היא לא חלק מהקוד.
מרחק בין שתי מילים הוא מספר הביטים שיש לשנות על מנת לקבל מילה אחת מהשנייה.
המרחק הכי קצר בין 2 מילות קוד.
בקוד מרחק הקוד הוא 3.
גילוי ותיקון שגיאות
המרחק המינימלי קובע את יכולת הגילוי והתיקון של שגיאות של קוד.
כאשר מנתחים יכולת גילוי שגיאות של קוד, עלינו להניח מה מספר השגיאות המקסימלי שעלולות להתרחש בזמן שידור.
נניח יש לנו את הקוד:
ונניח שהייתה טעות אחת וקיבלנו את המילה . במצב זה אנו יודעים כי נשלחה או המילה או המילה .
אם המרחק המינימלי הוא ובמילת הקוד נפלה טעות אחת ניתן לגלות אותה אך לא לתקנה.
אם המרחק המינימאלי הוא ובמילת הקוד נפלו שתי טעויות, אזי לא נוכל להבטיח גילוי של השגיאה.
נניח אם היו שתי שגיאות וקיבלנו - זוהי מילה שקיימת בקוד ולכן לא נדע על טעות.
אם המרחק המינימלי הוא 3. נניח בקוד הבא:
- ניתן לגלות עד 2 טעויות.
- אם מניחים שלכל היותר יש טעות 1 בלבד, ניתן לתקנה.
באופן כללי:
יהי קוד בעל מרחק קוד . אזי, ניתן לגלות עד טעויות.
בהנחה שמספר הטעויות הוא לכל היותר אז ניתן לתקנן.
ננסה לחפש דרך לשפר את יכולת התיקון בקוד מבלי לשנות את המידע המקורי.
בדיקת זוגיות
נניח עבור הקוד:
נוסיף ביט לקצה כך שמספר האחדים במילת הקוד(כולל סיבית הזוגיות) יהיה זוגי עבור . נניח עבור אותן מילים ממקודם נקבל:
ביט הזוגיות מתקבל מ- שאר הסיביות:
עבור קוד עם מרחק קוד אי-זוגי, הוספת סיבית הזוגיות תגדיל את מרחק הקוד ב-.
במידה ומרחק הקוד הינו זוגי, אזי מרחק הקוד לא ישתנה.
קוד חזרות
כל ביט משודר פעמים.
עבור לדוגמה:
מינוח: להפעיל קוד חזרות על קוד עם .
עבור המילים:
נקבל בקוד חזרות עם :
מרחק הקוד המקורי היה 2 ואילו לאחר השינוי מרחק הקוד הינו כלומר .
קוד .
כל מילת הקוד באורך מכילות בדיוק אחדים.
מספר המילים בקוד יהיה .
מרחק הקוד: 2 (לכל ו-)
⇐ יכולת גילוי של שגיאה בודדת.
אסמבלי
כשאנחנו רוצים לקמפל קוד בשפת או בשפה עילית אחרת - לרוב, המהדר לוקח את הקוד ומתרגם אותו לשפת אסמבלי, שאז האסמבלר(שבדרך כלל בנוי לתוך מערכת ההפעלה) יקח את האסמבלי ויהפוך אותו לקוד מכונה.
באסמבלי אין לנו משתנים. יש לנו רק רגיסטרים(אוגרים בעברית) אשר הם בנויים לתוך החומרה והם ממש ממש מהירים. הם סופיים ומסוגלים לאסחן רק מספר סופי של ביטים.
פעולות יכולות להתבצע רק על רגיסטרים.
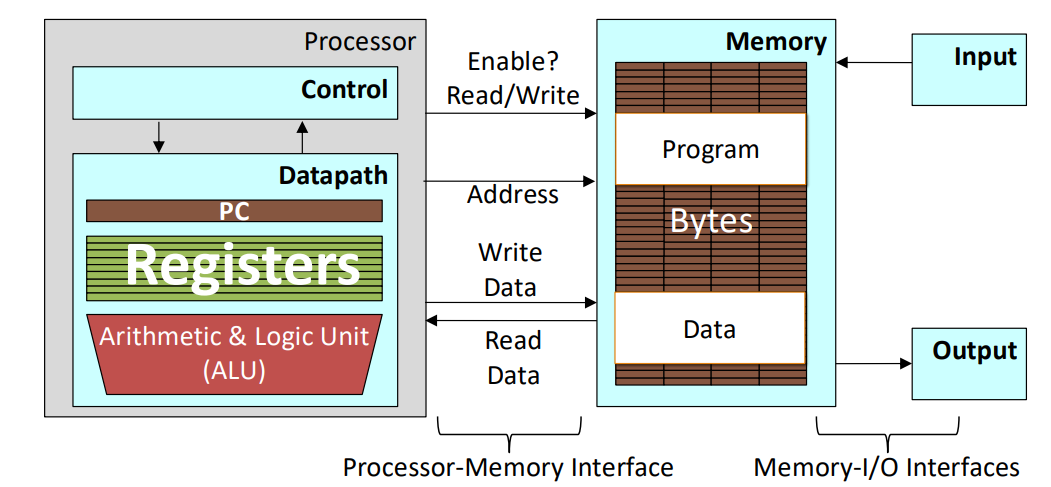
כמה רגיסטרים יש לנו בריסק-5? יש לנו רגיסטרים שכל אחד מהם הוא בגודל של מילה( ביטים בקורס זה).
הרגיסטר הוא מיוחד וערכו תמיד .
מכיוון שיש לנו מספר מוגבל של רגיסטרים נשאף לבנות תוכנות שמשתמשות בזיכרון ביעילות.
הרגיסטרים שיש במערכת:
| Name | Reg # | Use | Saver |
|---|---|---|---|
| $zero | 0 | Constant 0 | - |
| ra | 1 | Return Address | Caller |
| sp | 2 | Stack Pointer | Callee |
| gp | 3 | Global Pointer | - |
| tp | 4 | Thread Pointer | - |
| t0-t2 | 5-7 | Temp | Caller |
| s0-s1 | 8-9 | Saved Registers | Callee |
| a0-a7 | 10-17 | Function arguments/return values | Caller |
| s2-s11 | 18-27 | Saved Registers | Callee |
| t3-t6 | 28-31 | Temp | Caller |
| כשאנחנו רוצים לגשת לכתובת בזיכרון אנו נעשה זאת לפי בתים ולא לפי ביטים(כל בית הוא 8 ביטים): | |||
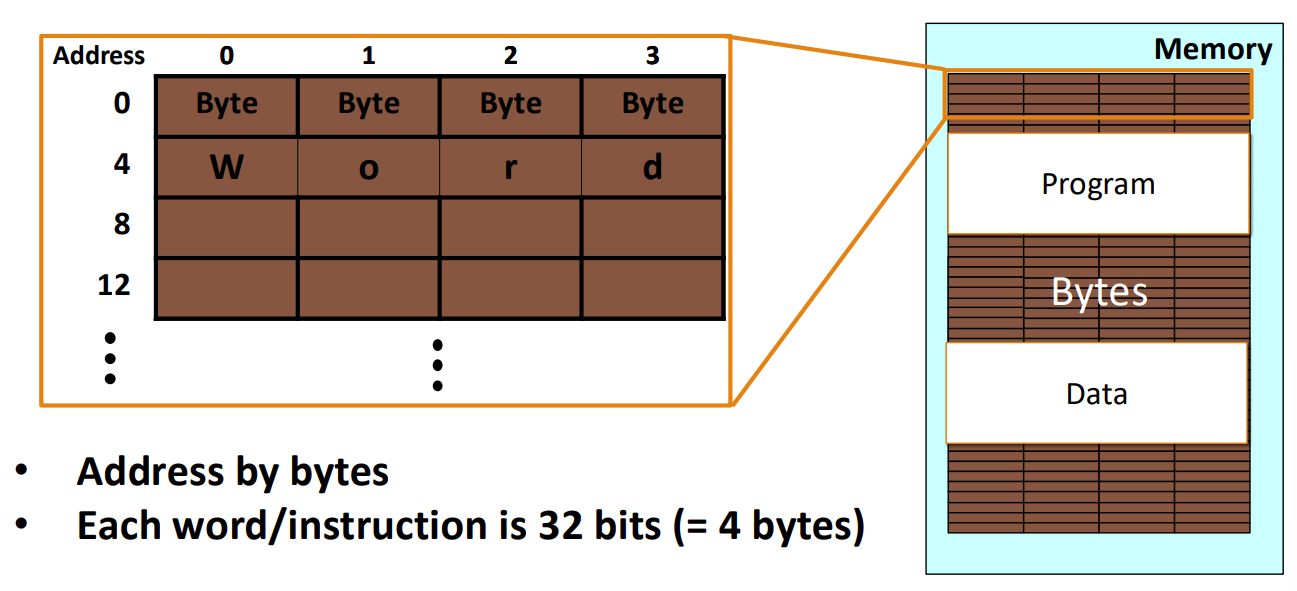 | |||
| אם נחתנו באמצע מילה אז הוא יספור 4 בתים מהנקודה בה נחתנו(ולכן מומלץ לא לעשות את זה) |
תרגול
נניח שיש לנו מערך בזיכרון שמכיל:
int* arr = {1,2,3,4,5,6,0};
הערך של המערך הוא כפולה של ומאוחסן ברגיסטר .
מה הקוד הבא יבצע?
lw t0,12(s0)
slli t1,t0,2
add t2,s0,t1
lw t3,0(t2)
addi t3,t3,1
sw t3,0(t2)
lw t0,0(s0)
addi t1,x0,-1
xor t0,t0,t1
addi t0,t0,1
נסתכל על מה כל שורה עושה ולאחר מכן נגלה מה הקוד הזה עושה בכללותו.
השורה lw t0,12(s0) טוענת את הערך במערך לרגיסטר .
השורה slli t1,t0,2 מזיזה את הביטים ב- ב-2 שמאלה ומציבה זאת ב-. כלומר, כעת .
השורה add t2,s0,t1 מחברת בין שבו יש את הכתובת של ל- ומציבה את הערך ב-. כלומר, ב- תהיה את הכתובת של האיבר החמישי במערך.
השורה lw t3,0(t2) מציבה ב- את הערך .
השורה addi t3,t3,1 מציבה ב- את .
השורה sw t3,0(t2) מציבה את הערך שנמצא ב- במקום בזכרון שאליו מצביע שהוא .
לכן, קטע הקוד הזה מבצע ואז .
השורה lw t0,0(s0) שמה ברגיסטר את הערך .
השורה addi t1,x0,-1 מציבה ברגיסטר את הערך .
השורה xor t0,t0,t1 מבצעת את פעולת ה- בין המילים ברגיסטרים ומאחסנת זאת ברגיסטר . מכיוון ש- הוא ולכן הוא בעצם רק אחדים, אז זה בעצם מבצע .
השורה addi t0,t0,1 מבצעת .
קטע הקוד הזה שם ברגיסטר את המשלים ל- של .
כתבו את התנאי רק באמצעות beq ו-bne
הפקודה slt t0,s0,s1 מבצעת:
לכן, נוכל להשתמש בה לפי ההשוואה הבאה bne t0,x0,label. זאת מכיוון שאנו יודעים כי רגיסטר הוא תמיד ואין לנו דרך לדעת באיזה רגיסטר יש אם לא השמנו בו את ערך זה.
כתבו את התנאי רק באמצעות beq ו-bne
נוכל להשתמש באותה פקודה ממקודם רק הפוך: slt t0,s1,s0 ואז נקבל את הערך ב- אם .
לכן, נוכל עכשיו להשתמש בפקודת ההשוואה: beq t0,x0,label.
כתבו את הנתאי רק באמצעות beq ו-bne
נציב ברגיסטר את הערך כך: addi t1,x0,1
כעת, נשתמש שוב בפקודה כך: slt t0,t1,s0 שתיתן לנו אם .
לבסוף, נבצע את ההשוואה: bne t0,x0,label.
ניתן להשתמש בפקודה slti t0,s0,2 כדי לקבל אם מתקיים ואז להשתמש בפקודת ההשוואה beq t0,x0,label.
זה שימוש יותר טוב בזיכרון - אז זה טכנית יותר טוב.