חזור לתיקייה: גליון 2

חלק יבש

חיפוש בתיקיה
Ctrl K
לחץ כאן או הקש Ctrl K כדי לחפש בכל התיקיה
  • 2.0 - תיאור היחידה האריתמטית(המכפל)
  • 2.1 - מכונת מצבים Mealy
  • 2.2 - שינוי למכונת המצבים
  • 2.3 - מימוש בקוד
  • 2.4 - כתיבת קוד אסמבלי
  • סימולציות
  • סימולציה עבור המערכת הרגילה
  • סימולציה עבור המערכת המהירה

חלק יבש

00440252

מערכות ספרתיות ומבנה המחשב

רשימות הרצאה לקריאה בשבת

חלק יבש

הופק מתוך תקיית התואר של שקד

uni-folder.vercel.app

2.0 - תיאור היחידה האריתמטית(המכפל)

אנו מחלקים את הביטים לקבוצות ומבצעים כפל כמו בבסיס 101010 כך שמתקיים:

(a+b+c+d)(x+y)=ax+bx+cx+dx+ay+by+cy+dy(a+b+c+d)(x+y)=ax+bx+cx+dx+ay+by+cy+dy(a+b+c+d)(x+y)=ax+bx+cx+dx+ay+by+cy+dy

את המספר bbb נחלק לשתי קבוצות של 161616 בטים ואת המספר aaa נחלק לארבע קבוצות של 888 ביטים.
לאחר שמתבצע כפל של קבוצה מסויימת, המכפלה נכנסת לקופסה השחורה של המכפיל 16×816\times 816×8 ויוצאת אל המזיזים(shiftersshiftersshifters) אשר מזיזים בהתאם למיקום של המכפלה, אם נניח מכפילים את 888 הביטים הראשונים של aaa עם 161616 הביטים הראשונים של bbb אז לא צריך הזזה בכלל, אך אם מכפילים את 161616 הביטים הראשונים של bbb עם 888 הביטים שנמצאים אחרי 161616 הביטים הראשונים ב-aaa (כלומר, הביטים 16:2416:2416:24) אז אנו צריכים להשתמש ב-shifter16shifter16shifter16.
לאחר שאנו בוחרים את המיקום לביטים שהתקבלו, אנו מחברים אותם עם הקודמים באמצעות המחבר של 646464 ביטים ואז התוצאה נשמרת ברגיסטר.

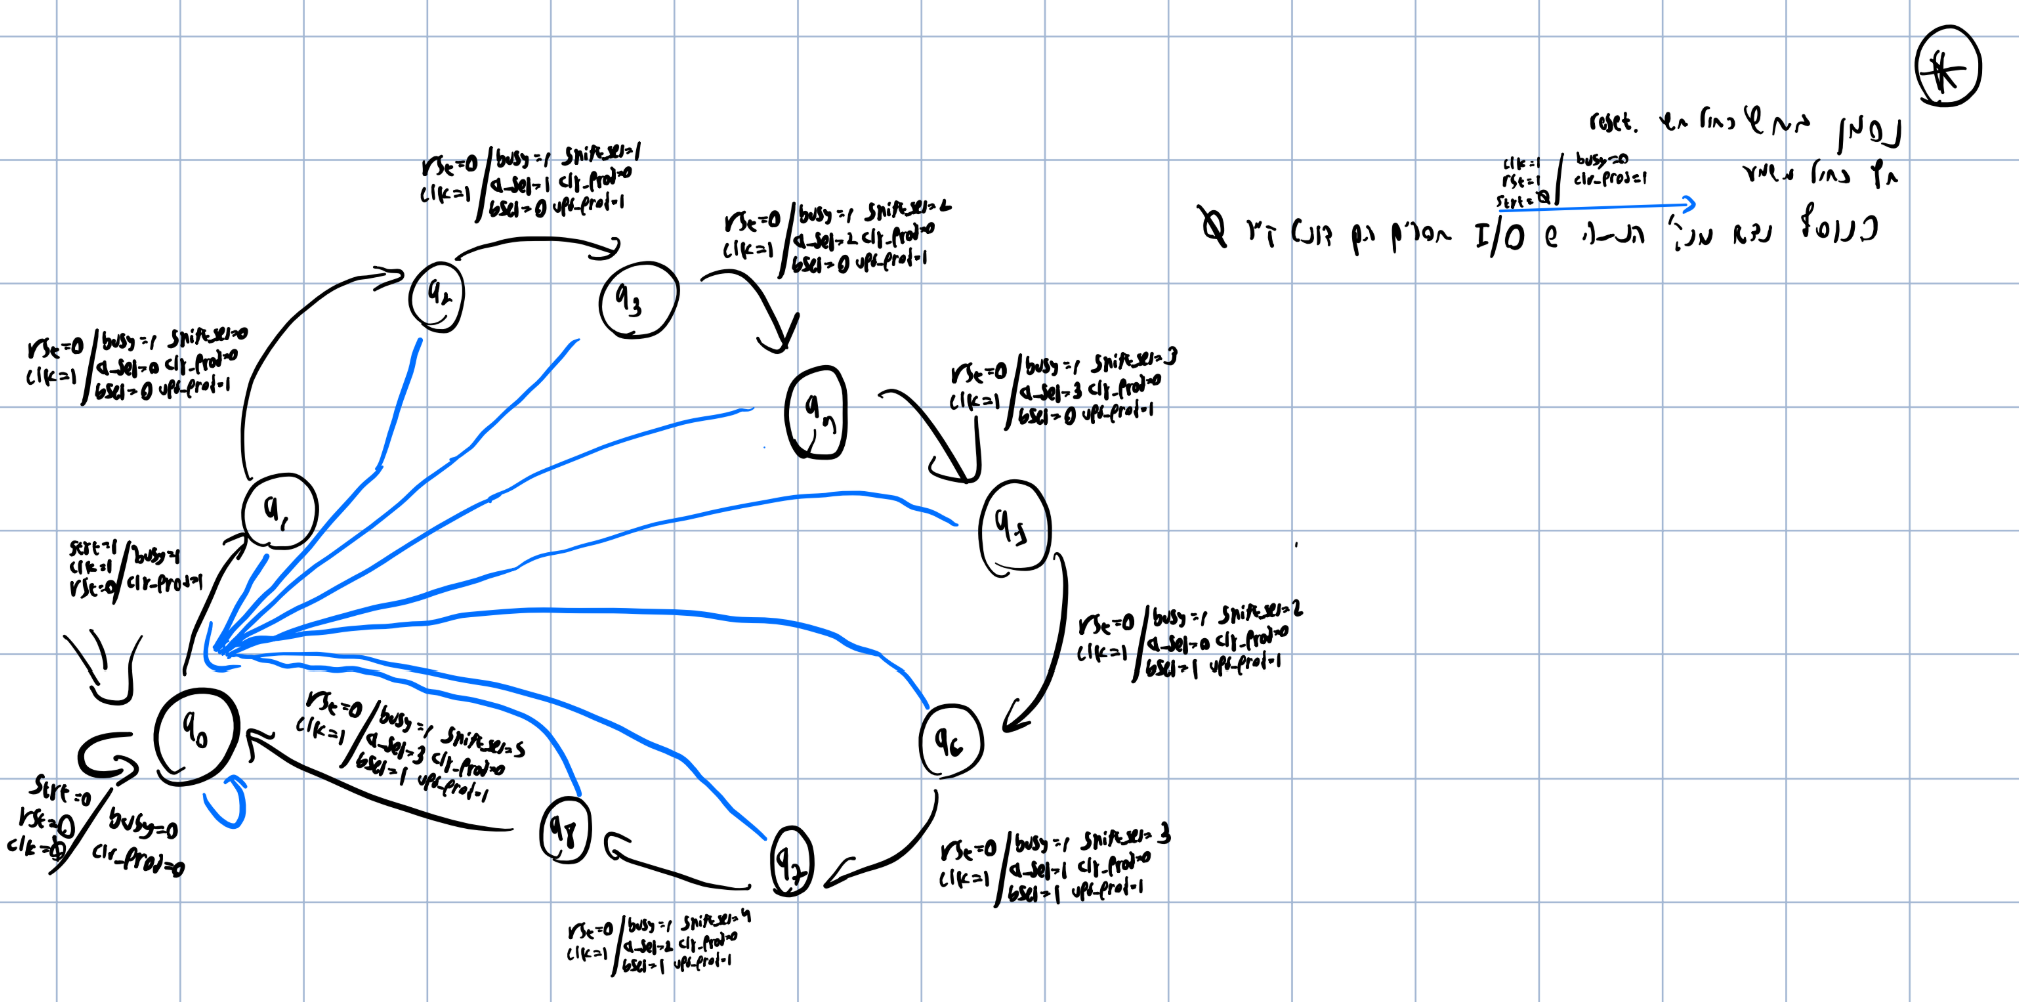
2.1 - מכונת מצבים MealyMealyMealy

נגדיר:

⋆=start=∅clk=∅rst=1/busy=0,  a_sel=∅,  b_sel=∅,shift_sel=∅,  upd_prod=∅,clr_prod=1\star = \left.\begin{matrix} start=\varnothing \\ clk=\varnothing\\ rst=1 \end{matrix} \middle/ \begin{align*} & busy=0,\; a\_sel=\varnothing,\; b\_sel=\varnothing, \\ & shift\_{sel}=\varnothing,\; upd\_{prod}=\varnothing, \\ & clr\_{prod}=1 \end{align*}\right.⋆=start=∅clk=∅rst=1​/​busy=0,a_sel=∅,b_sel=∅,shift_sel=∅,upd_prod=∅,clr_prod=1​

ואז נסתכל על מכונת המצבים הבאה, כאשר בכל מצב, אם clk=0clk=0clk=0 המצב או הקלט לא משתנה:
​סימולציה 2 - יש לי מכונה.png

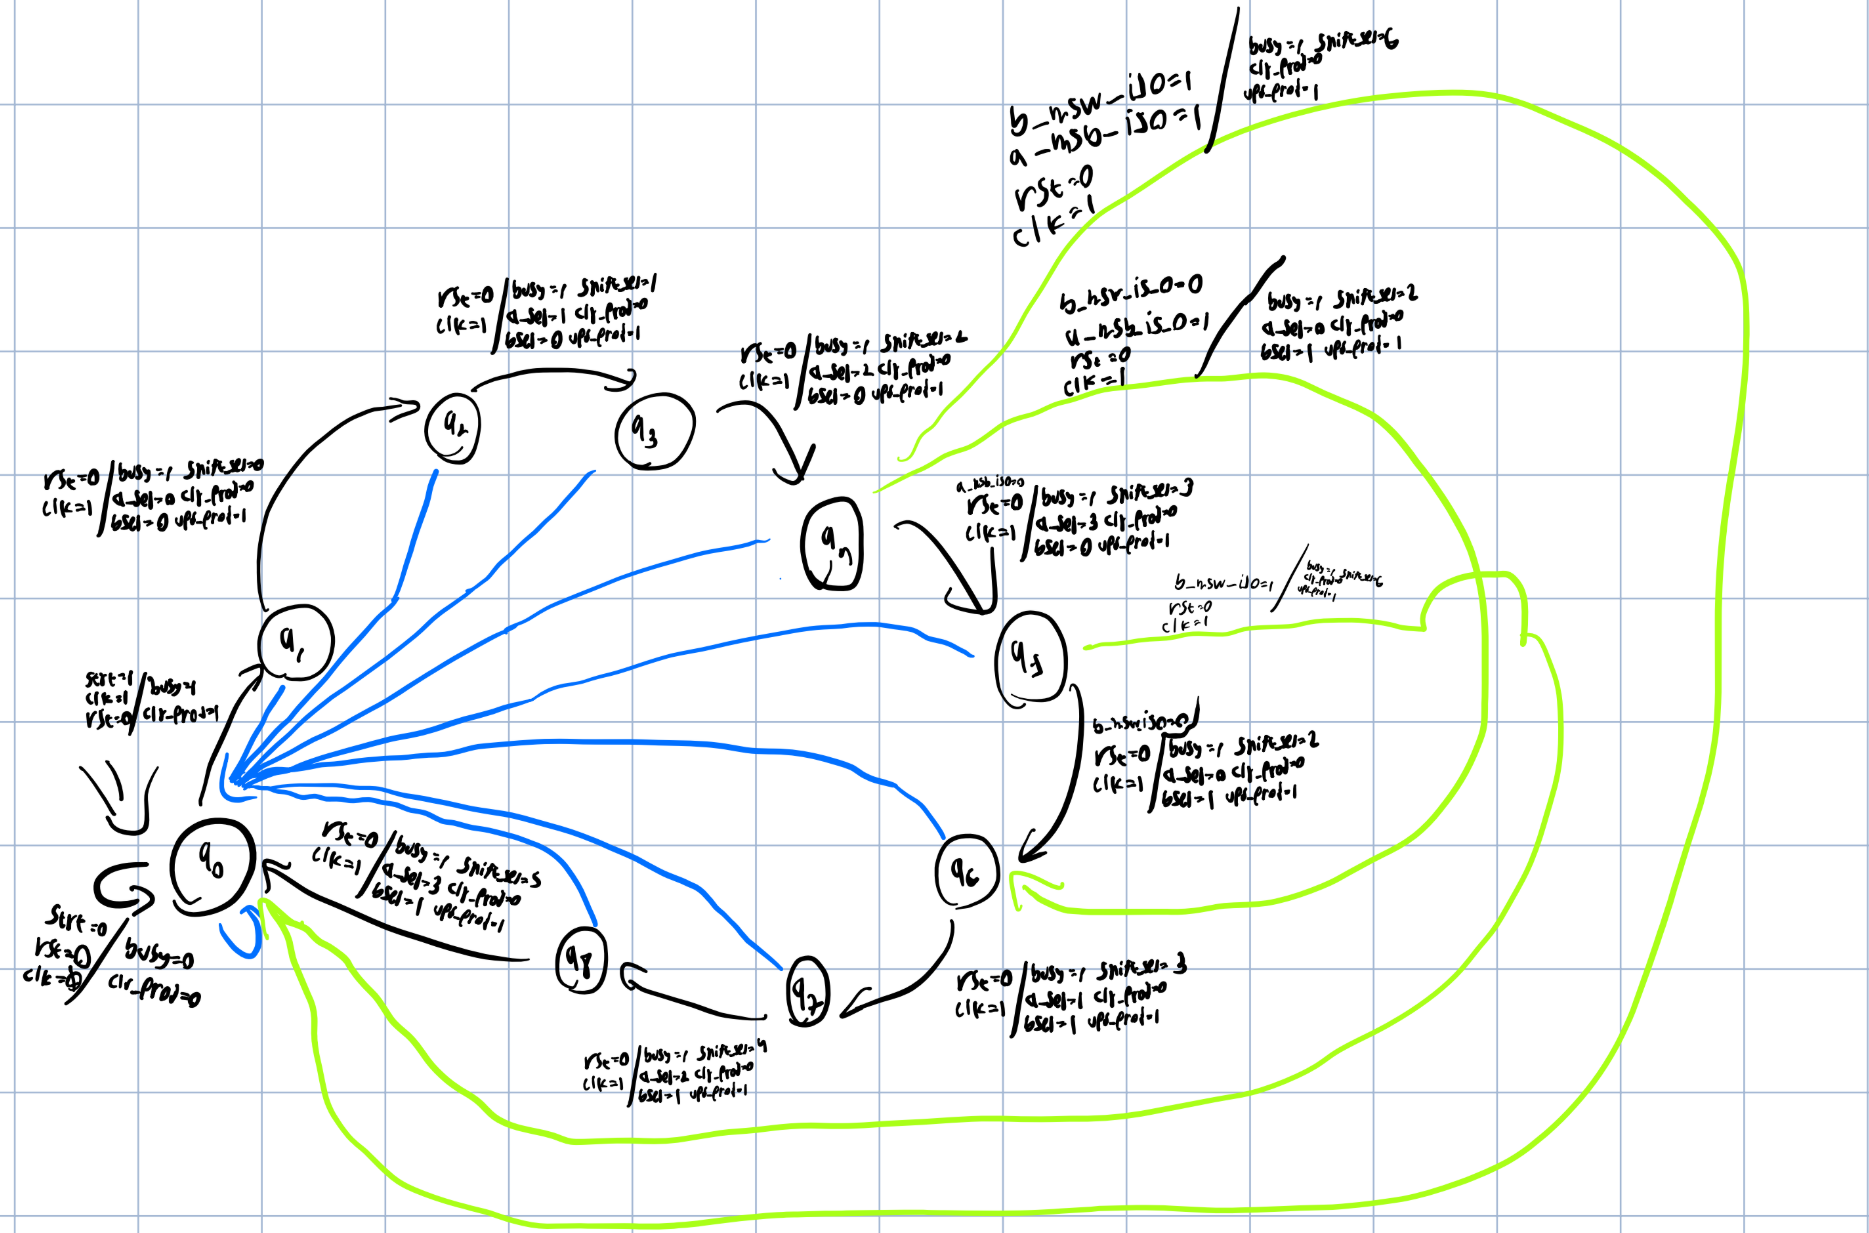
2.2 - שינוי למכונת המצבים

​סימולציה 2 - יש לי מכונה 2.png

2.3 - מימוש בקוד

אם נכתוב תוכנה שכזו במחשב נדרש להרבה פחות מחשבה שכן לא נצטרך לדאוג לחוטים ולמכונת מצבים ונוכל לשלוט בהכל עם לולאות forforfor פשוטות יחסית.
הנה האלגוריתם ב-pesudo  codepesudo\;codepesudocode:

Algorithm 1 8Nx8N Multiplier

Input: 2, 8N bit unsigned integers: a, b

Output: 1 8N bit unsigned integer that represents a*b

1:sum←0sum \gets 0sum←0

2:for i=0i=0i=0 to N2−1\frac{N}{2}-12N​−1 do

3:for j=0j=0j=0 to N−1N-1N−1 do

4:current←a[8⋅j    :    8⋅(j+1)]⋅b[16⋅i    :    16⋅(i+1)]current \gets a{\Large [} 8 \cdot j \;\;{\Large :}\;\; 8\cdot(j+1) {\Large]} \cdot b{\Large [}16\cdot i\;\;{\Large :}\;\;16\cdot (i+1){\Large ]}current←a[8⋅j:8⋅(j+1)]⋅b[16⋅i:16⋅(i+1)] // Uses the 16x8 Multiplier given for the ⋅\cdot⋅.

5:sum←sum+current⋅28(2i+j)sum \gets sum + current \cdot2^{8(2i+j)}sum←sum+current⋅28(2i+j)

6:end for

7:end for

מה שאנו עושים מאוד דומה לאיך שהמערכת עובדת בחומרה, אנו מחלקים את המספרים שלנו ל-888 ו-161616 ביטים ואז כופלים כל אחד מהם בכל אחד אחר באמצעות המעבד שיכול להכפיל(ראו את השורה עם ההערה מימין)
לאחר מכן, אנו מחברים לסכום את המספר החדש שלנו ומזיזים אותו את כמות הביטים הרצויה באינטרבלים של 888 או 161616 בהתאם לקבוצה שבחרנו ב-aaa וב-bbb. (להסבר מפורט יותר ראו את סעיף 2.0 וההסבר על ה-shiftershiftershifter-ים)

נשים לב כי אנו מבצעים NNN הכפלות, N2\frac{N}{2}2N​ פעמים ולכן, יש סך הכל, N22\frac{N^2}{2}2N2​ הכפלות ולכן, הסיבוכיות הזמן הינה Θ(N2)\Theta(N^2)Θ(N2).

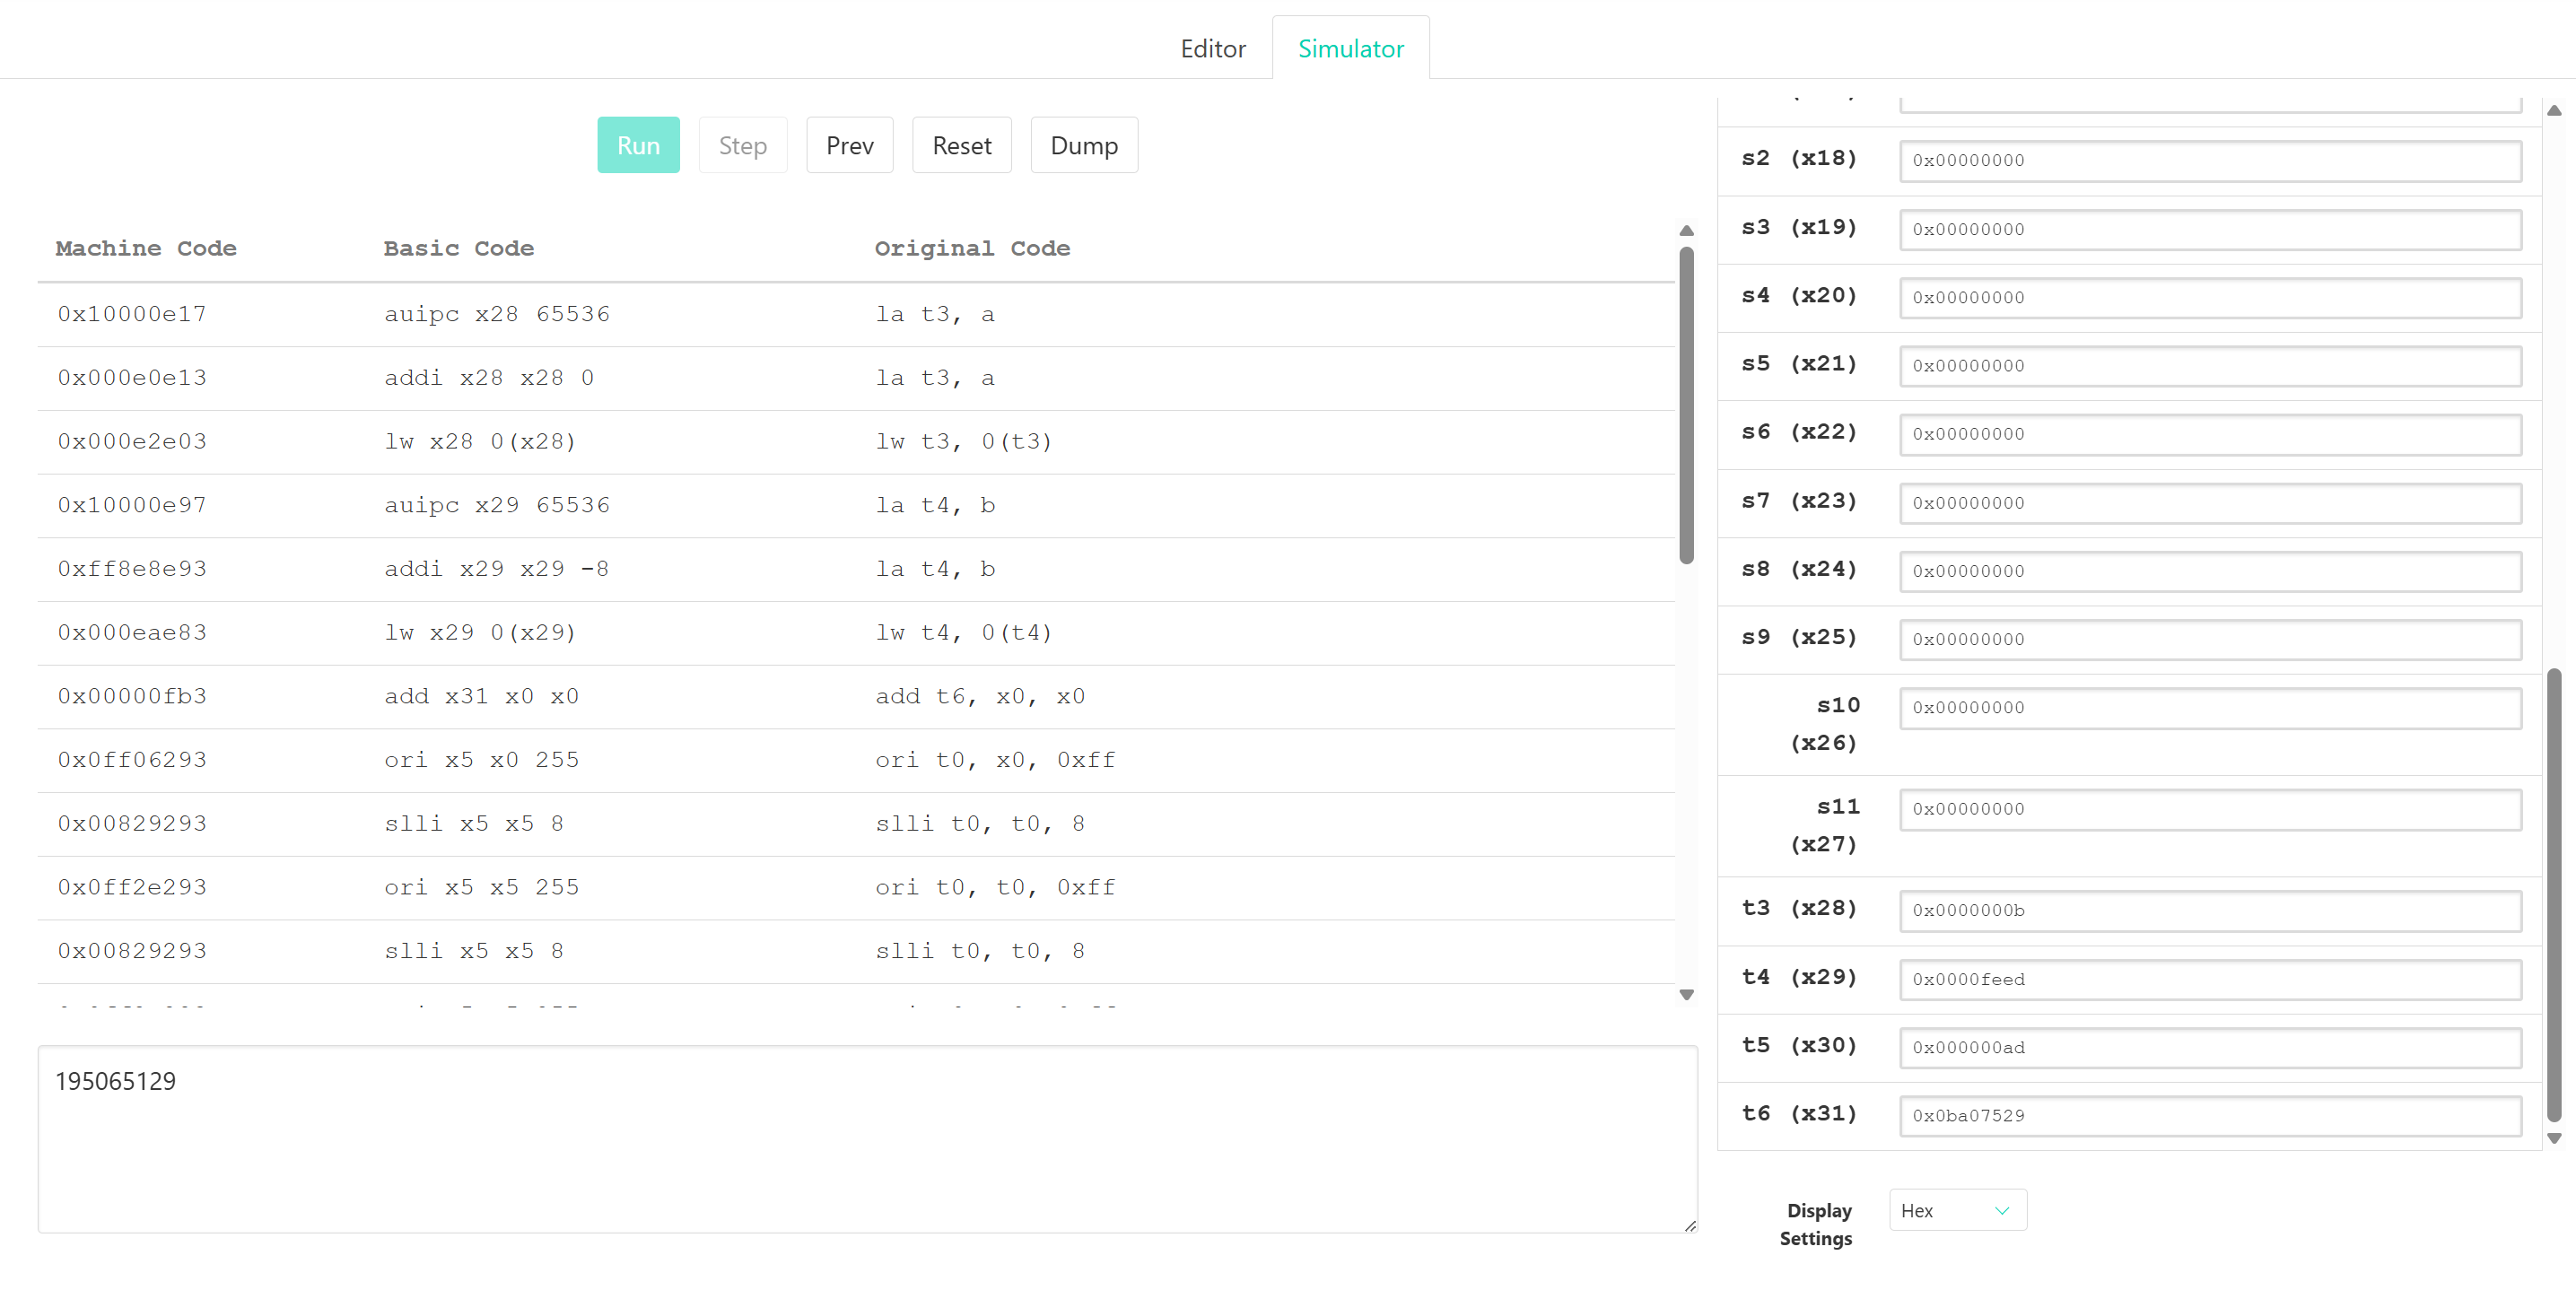
2.4 - כתיבת קוד אסמבלי

​digitalSystems-Sim2-imageOfAssembly.png

יש 101010 פקודות על מנת לבצע את אלגוריתם הכפל, לכן, ישנם 111111 מחזורי שעון מהכנסת המספרים עד קבלת המכפלה.

סימולציות

סימולציה עבור המערכת הרגילה
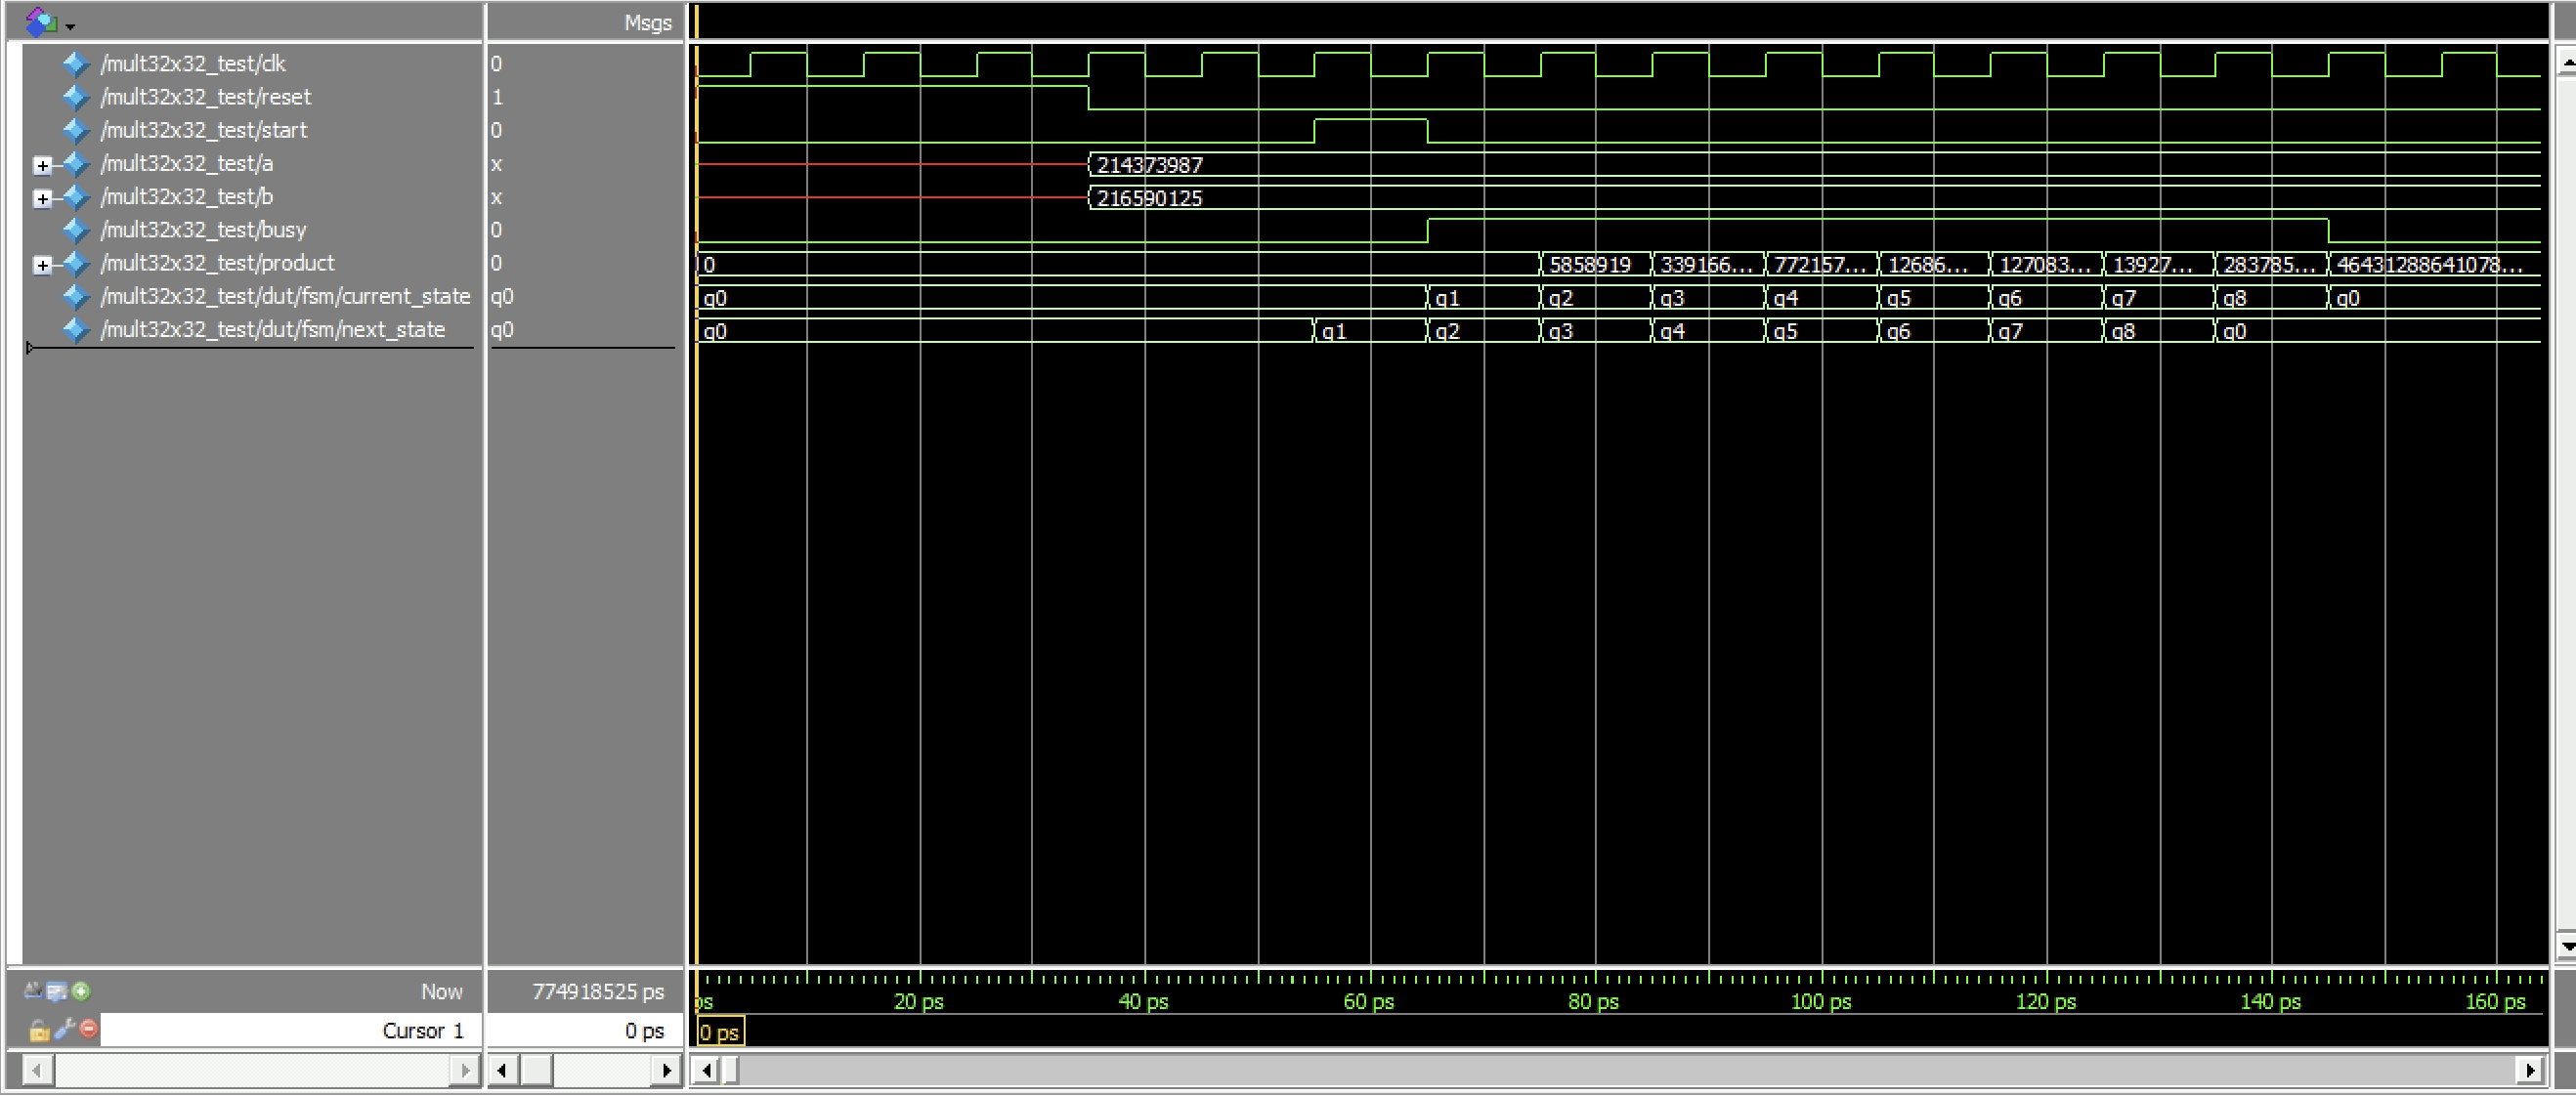
​digitalSystemsAndComputerArcitucture-Sim2-SystemVerilogRun-1.png

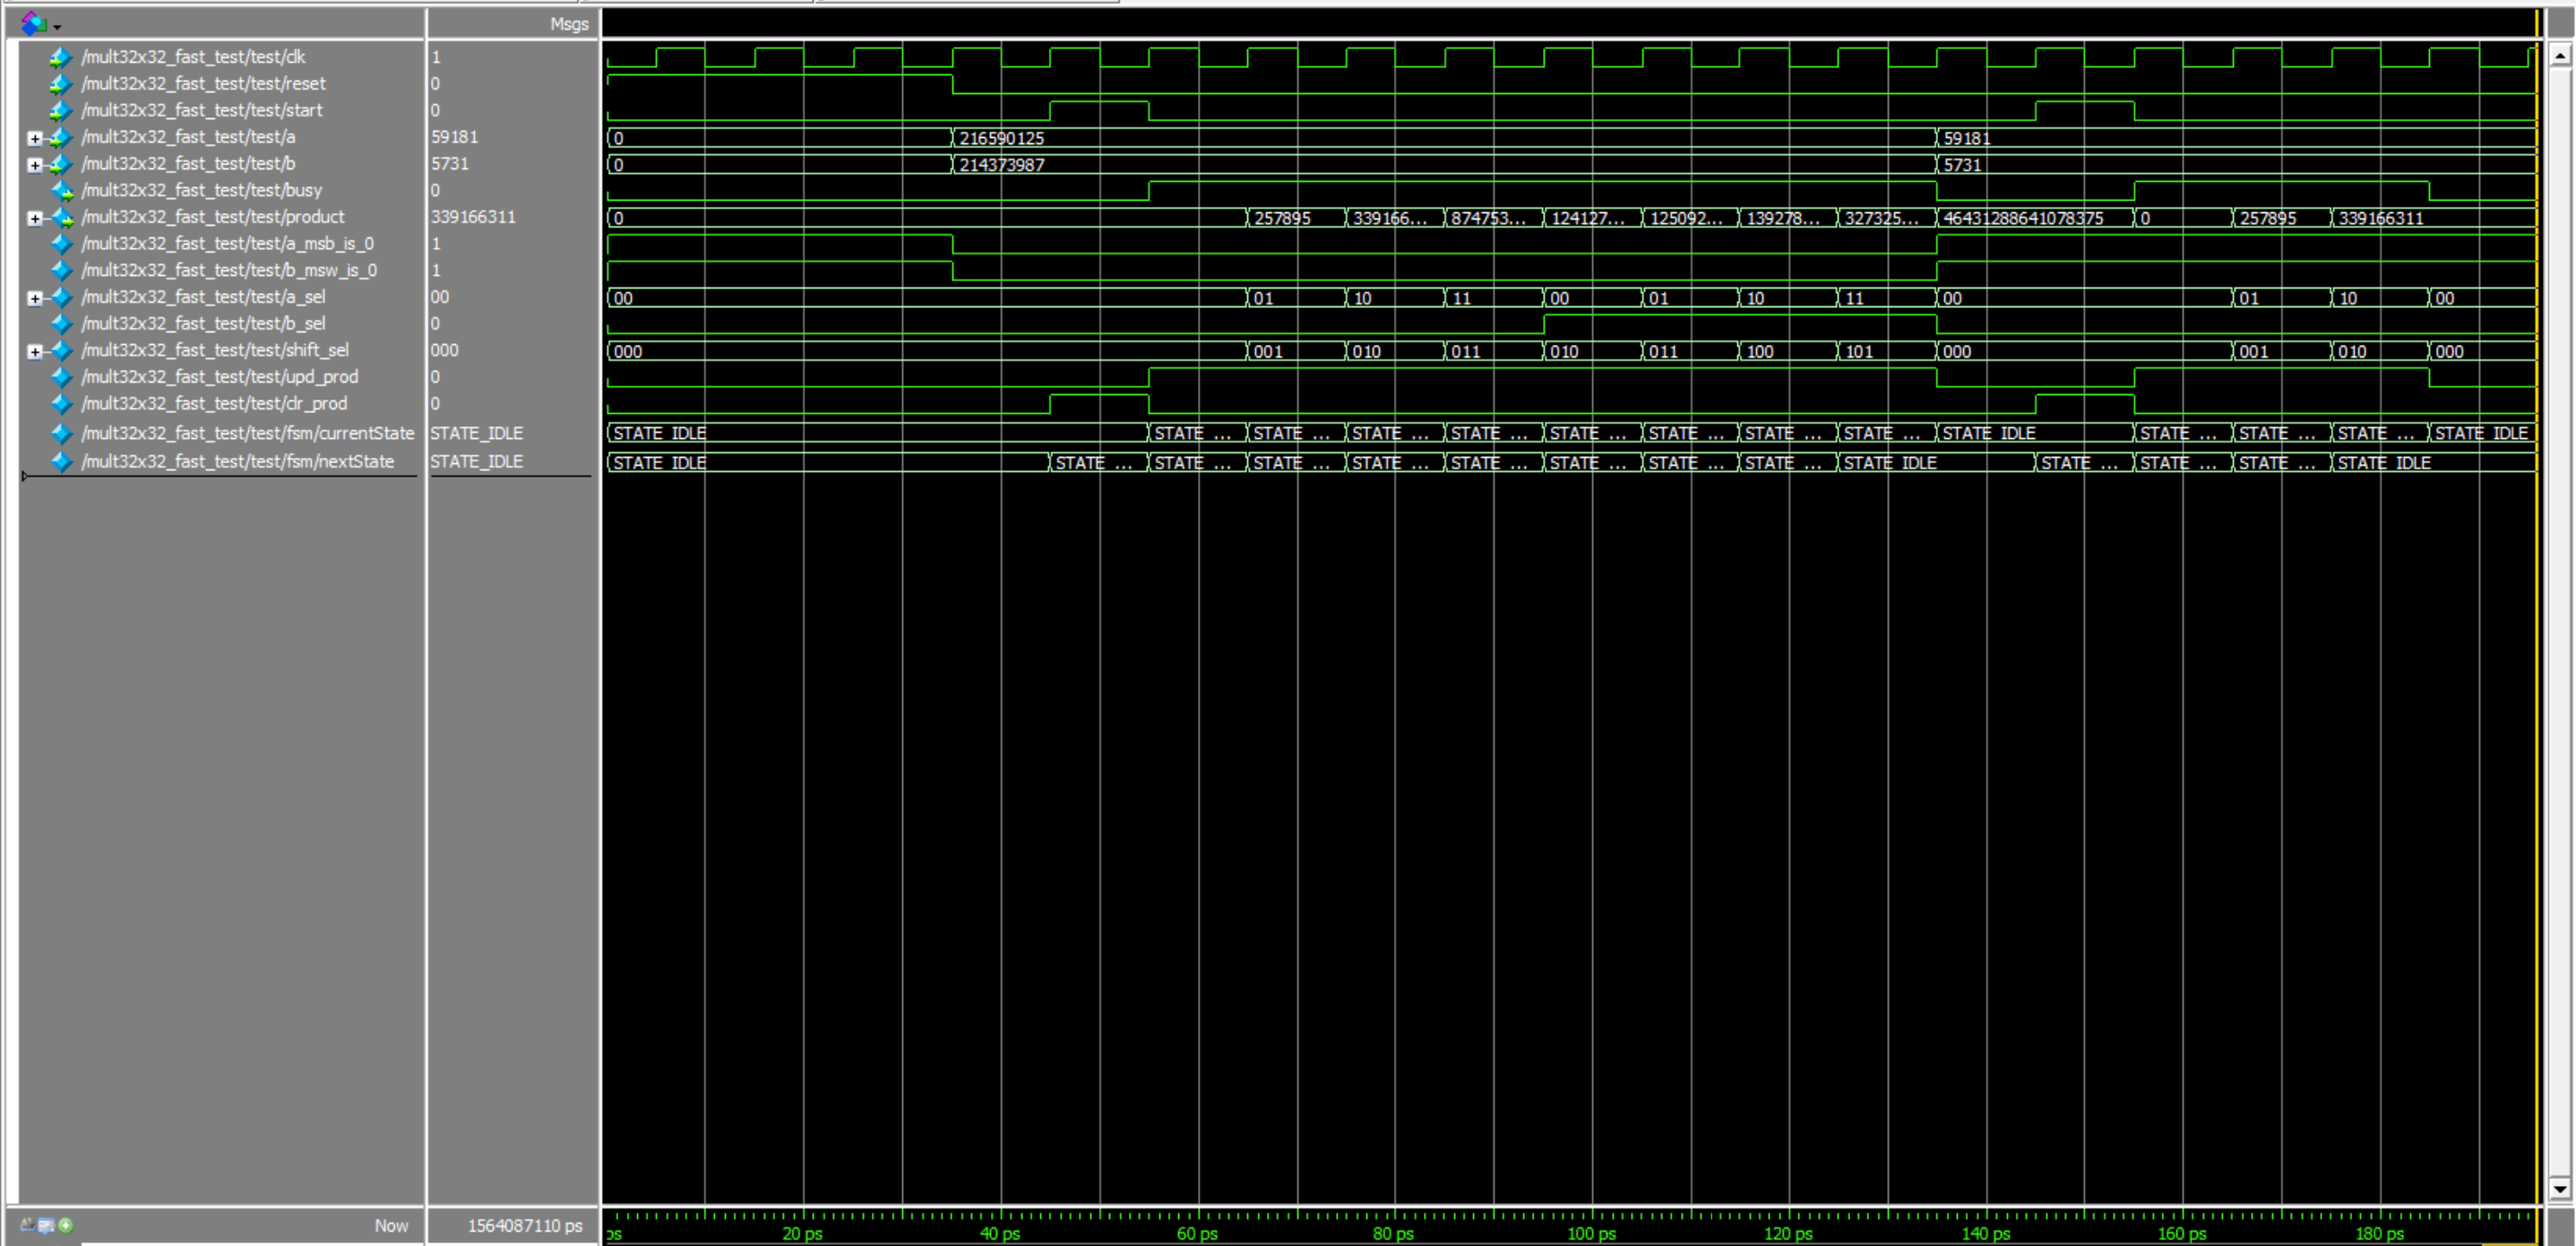
סימולציה עבור המערכת המהירה

​סימולציה 2 - תמונת גלים 1.png