הכל התחיל ממחשבים שלא יכלו לעשות שום דבר ללא שיכוונו אותם ידנית. לאחר מכן, יצרו דרך להגיד למחשב מה לעשות מבלי לחווט אותו מחדש. אנו נראה זאת כעת.
מודל וון נאומן
מודל זה מספר לנו כמה דברים על המחשב:
- פקודות הן רצף ביטים, כמו מספרים.
- ניתן לאחסן תוכנות בזכרון כמו מידע.
- ניתן לתכנת מחדש במהירות ולא צריך לשנות את החיווט במחשב.
מחשבים שעובדים לפי מודל זה נקראים מחשבי .
תוצאה 1: לכל יש כתובת
הכל מאוחסן בזכרון, גם מידע וגם הוראות ופקודות. לכן, להכל יש כתובת בזכרון.
מצביעים הם פשוט כתובת בזכרון.
רגיסטר אחד יכול לשמור את הכתובת של ההוראה שמתבצעת - לכתובת זו קוראים לשום .
רוב המידע שנעבוד איתו יהיה בקבוצות של ביטים.
הפקודות ו- נותנות גישה לזכרון פר מילה. (כלומר, אי אפשר לגשת לאמצע מילה כהתחלה)
ייצוג הפקודות
ב- כל מילה היא ביטים. למען הפשטות, גם פקודות הן ביטים ולכן מילה אחד בלבד.
כשאנו כותבים add x10,x11,x0 אין לזה באמת משמעות לחומרה. נרצה לתת משמעות לכך ולשם כך אנו מתרגמים אסמבלי לקוד מכונה.
יש לנו שישה סוגים של הוראות אשר לכל סוג תצורה שונה של כתיבה:
- - פעולות חישוביות המקבלות שני רגיסטרים.
- - פעולות חישוביות המקבלות רגיסטר ומספר קבוע.
- - אחסון
- - ענפים (התפצלות)
- - [משהו שלא הבנתי]
- - קפיצות.
הפורמטים עבורם הינם:
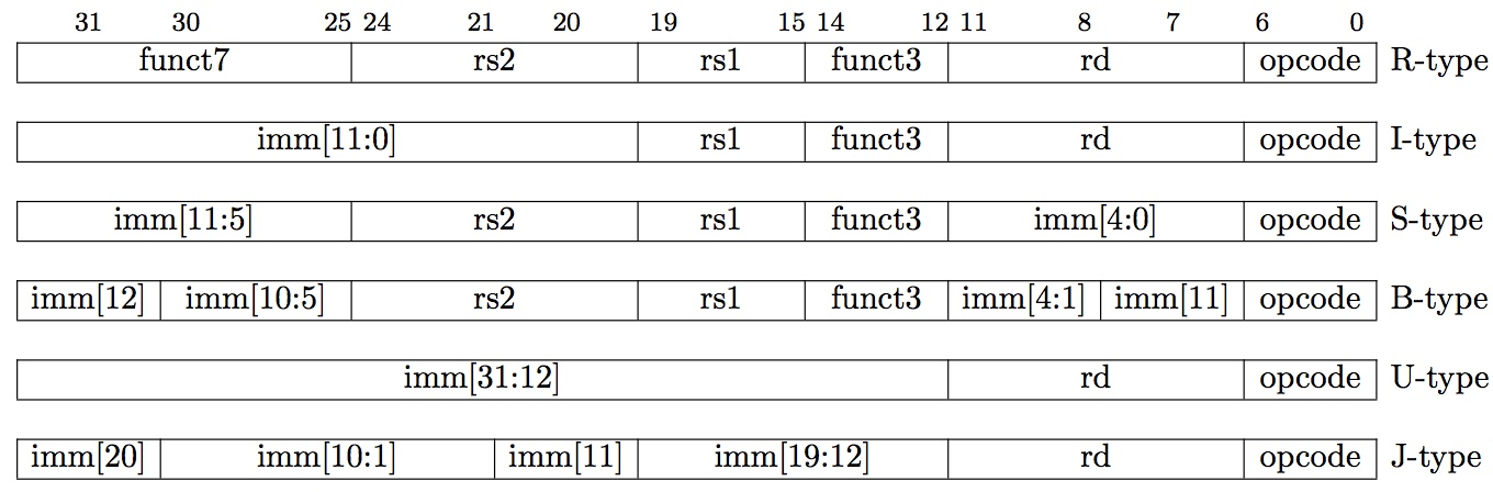
ה- אומר לנו מה היא הפקודה בדיוק.
בסוג :
- הערכים של אומרים לנו בדיוק מה אנו צריכים לעשות. ⟸ למה זה לא ערך אחד שאומר לנו מה לעשות? נראה בהמשך.
- הערכים אומרים אילו רגיסטרים מכילים את האופרנדים.
- הערך מבהיר איזה רגיסטר מקבל את התוצאה.
- כל בלוק רגיסטר מאחסן מספר שלם ללא סימן ברוחב ביטים. (מה שמתאים בדיוק ל- רגיסטרים)
עבור הקוד:
add x18,x19,x10
נקבל את:
ובאופן כללי:
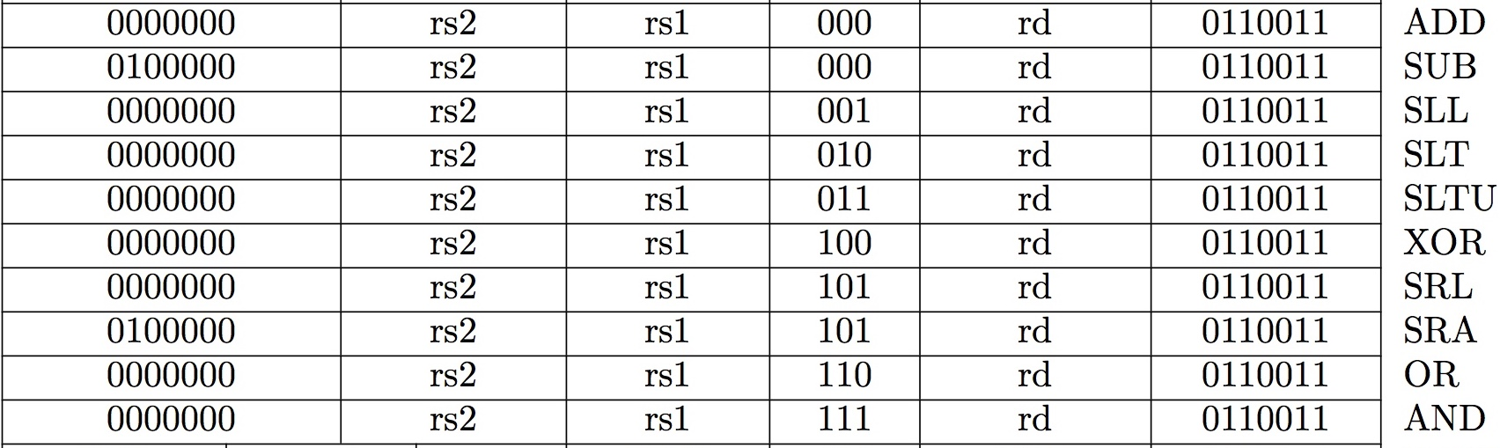
מה קורה עם פעולות עם מספר קבוע(מסוג )? איך הן מאחסנים מספרים קבועים ממש ממש גדולים? זה בדיוק למה זה פעולה מסוג אחר - כי אנו צריכים את המקום.
בסוג נקבל שבמקום יש לנו פשוט מקום לשים את המספר הקבוע שלנו באורך ביטים.
- הקבוע הוא תמיד עם סימן!!!!!
- בנוסף, בהמשך נראה כיצד אנו מתמודדים עם מספרים גדולים יותר מ- ביטים
נסתכל על הפקודה:
addi x15,x1,-50
ונרשום אותה כך:
ובאופן כללי:
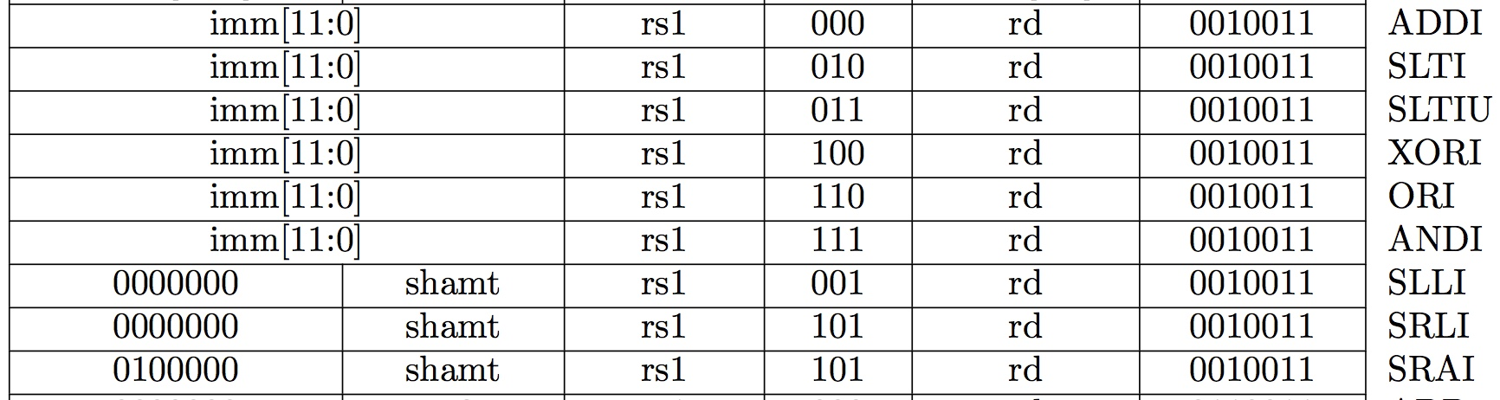
הפקודות עם מבצעים הזזה של מספר קבוע.
ההזזה יכולה להיות מקסימום ביטים ולכן אנו יכולים לתאר אותה באמצעות ביטים בלבד.
פקודות הטעינה שונות במקצת אך הן עדיין פקודות :
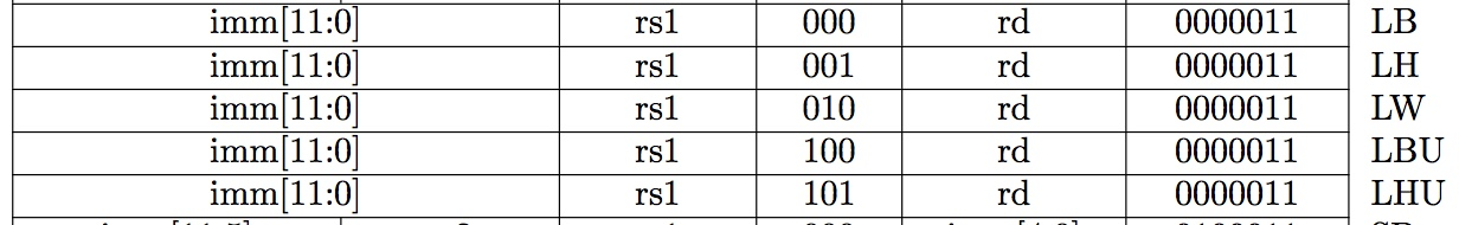
פקודות אחסון, מפורמט נראות כך:
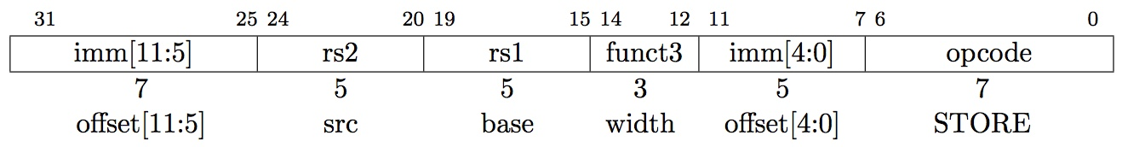
זה נראה מאוד דומה למה שראינו עד כה - המבנה זהה.
מהו ההבדל בעצם שיש לנו פה? לקחו את הסיביות ופיצלו אותם ל- ול-.
הפיצול נובע מבהירות הכתיבה: אין שום רגיסטר תוצאה בפקודות , יש לנו שני רגיסטרי מקור. לכן, כדי להשתמש באותם חיווטים של החומרה, נדרש ששני רגיסטרי המקור יצביעו לרגיסטרי המקור בפקודה.
עבור ה- אין שימוש, ולכן נוכל לקחת את המקום שלו ולהשתמש בו עבור המקום שלנו בזכרון.
עבור הפקודה:
sw x14, 8(x2)
נקבל:
ובאופן כללי:
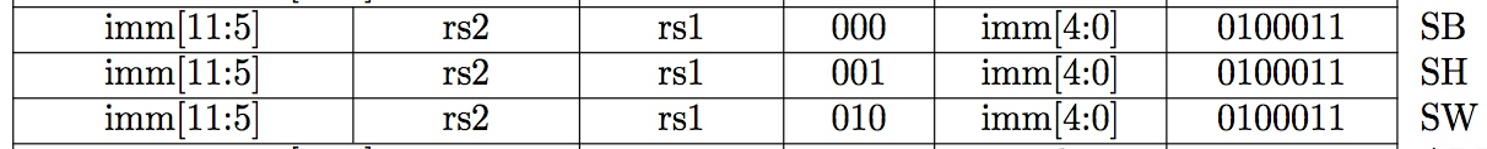
לאפקטיביות הכי טובה, תמיד נרצה להשתמש בבלוקים של ביטים וגם הגישה אל הזכרון תמיד תהיה כך.
ניתן לגשת למקום כלשהו מהאמצע באותה יעילות, אבל הוא פחות טוב.
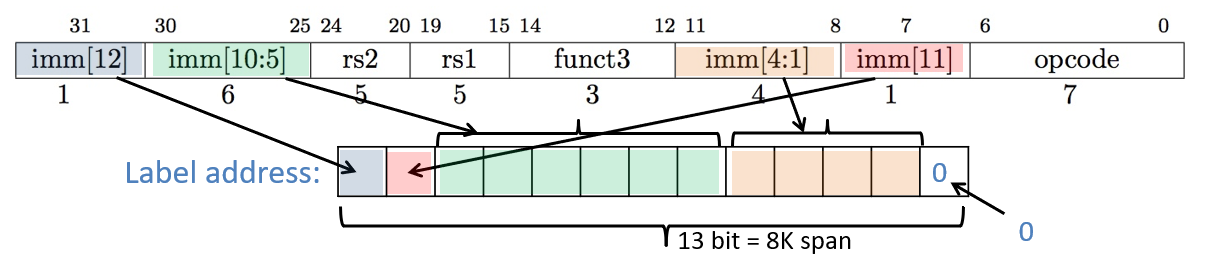
פקודות השוואה ועינוף(שליחה לענפים) - אלו מהסוג - לא כותבות לשום מקום, אלא רק קוראות ואז קופצות.
ה- בפקודה אינו כתובת אבסולוטית, אלא, ביחס למקום בו אנו נמצאים כרגע.
⟸ אנו משתמשים באיזור ה- על מנת לאחסן את הכתובת היחסית בתצורת המשלים לשתיים. ⟸ ניתן עם פקודות אלו לקפוץ עד מקסימום של פקודות למעלה או למטה.
לאור העובדה שיש לנו סיביות ואנו קופצים בקבוצות של בתים, הסיבית הראשונה תמיד תהיה אפס ולכן, המחשב ימלא אותה בעצמו תמיד.
מבנה הפקודות הוא בתכלס:

כאשר בחומרה נקבל:
עבור סט הפקודות:
Loop: beq x19,x10,End
       add x18,x18,x10
       addi x19,x19,-1
       j Loop
End:
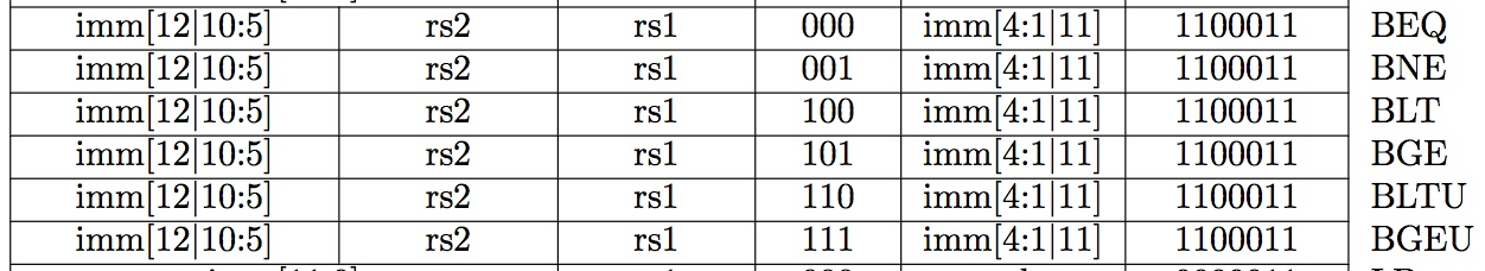
פקודת ההשוואה תהיה:
ובאופן כללי:
אם נרצה לקפוץ למקום מאוד רחוק, נשתמש בפקודות ה- שיכולות לעשות זאת.
bne x10,x0,next
j far
next: #next instruction
הפקודות מסוג הינן: ו-.
מטרת הפקודות האלו היא הכנסת מספר קבוע לתוך רגיסטר.
הפקודות האלו תמיד עובדות בזוג שכן לא ניתן לאחסן ביטים של מידע בנוסף לפקודה עצמה.
- הפקודה משמשת לבניית קבועים של ביטים והיא נראית כך:
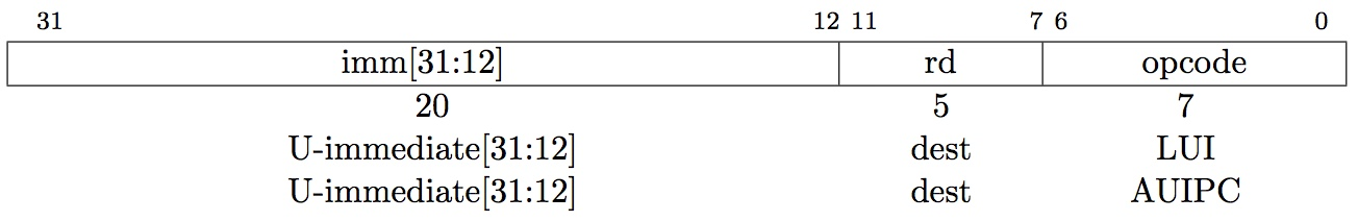
זה ממלא את הביטים הכי נמוכים עם אפסים ומאפשר לנו לשנות את הסיביות הכי גבוהות().
ביחד עם ניתן למלא את הסיביות האחרות כך:lui x10, 0x87654 # x10=0x87654 addi x10,x10,0x321 # x10=0x87654321
עם הדבר הזה יש בעיה ולשם כך נראה דוגמה:
lui x10, 0xDEADB    # x10=0xDEADB000
addi x10,x10, 0xEFF # x10=0xDEADAEEF
נשים לב כי ה- הוחלפה לנו עם . למה זה קורה? בגלל ש- יוצר בהתחלה, ה- חושב שזה מספר שלילי ומרחיב אותו עם -ים, מה שיוצר לנו בעיה שכן החיבור לא עובד יותר.
על מנת לסדר את זה, יצרו פסודו פקודה שמסדר את הבעיה הזו באמצעות תרגום והיא . כך לא נתעסק בכלל עם הפקודה שצריכה שתי פקודות.
liw x10, 0xDEADBEEF
- הפקודה מקבלת מספר, מחברת אותו ל- ואז שמה אותו ברגיסטר.
בפורמט ה- יש שתי פקודות: ו-.
- מבנה הפקודה הינו:
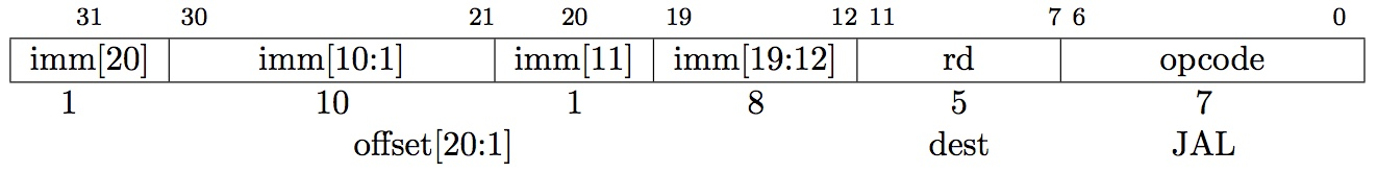
- הפקודה היא פסודו פקודה והיא בעצם משתמשת ב- ומבצעת כדי שלא ישאר מיקום חזרה.
- מכיוון שיש לנו פה רק רגיסטר אחד ואופקוד, נוכל לקפוץ ל- פקודות של ביטים.
- מבנה הפקודה הינו:
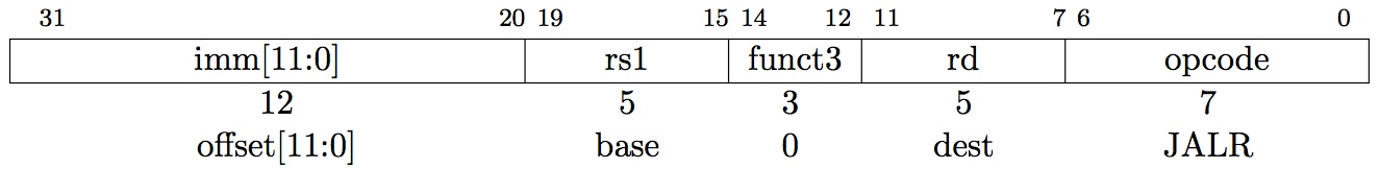
אשר מחבר את הערך של וה- ותבצע השמה של תוצאת החיבור ל-. (שזוהי הקפיצה)
נשים לב כי זה לא יחסי.
פה אין שום מנגנון של הוספת אפסים מימין. כדי להגדיל את המספר, מגדילים את .
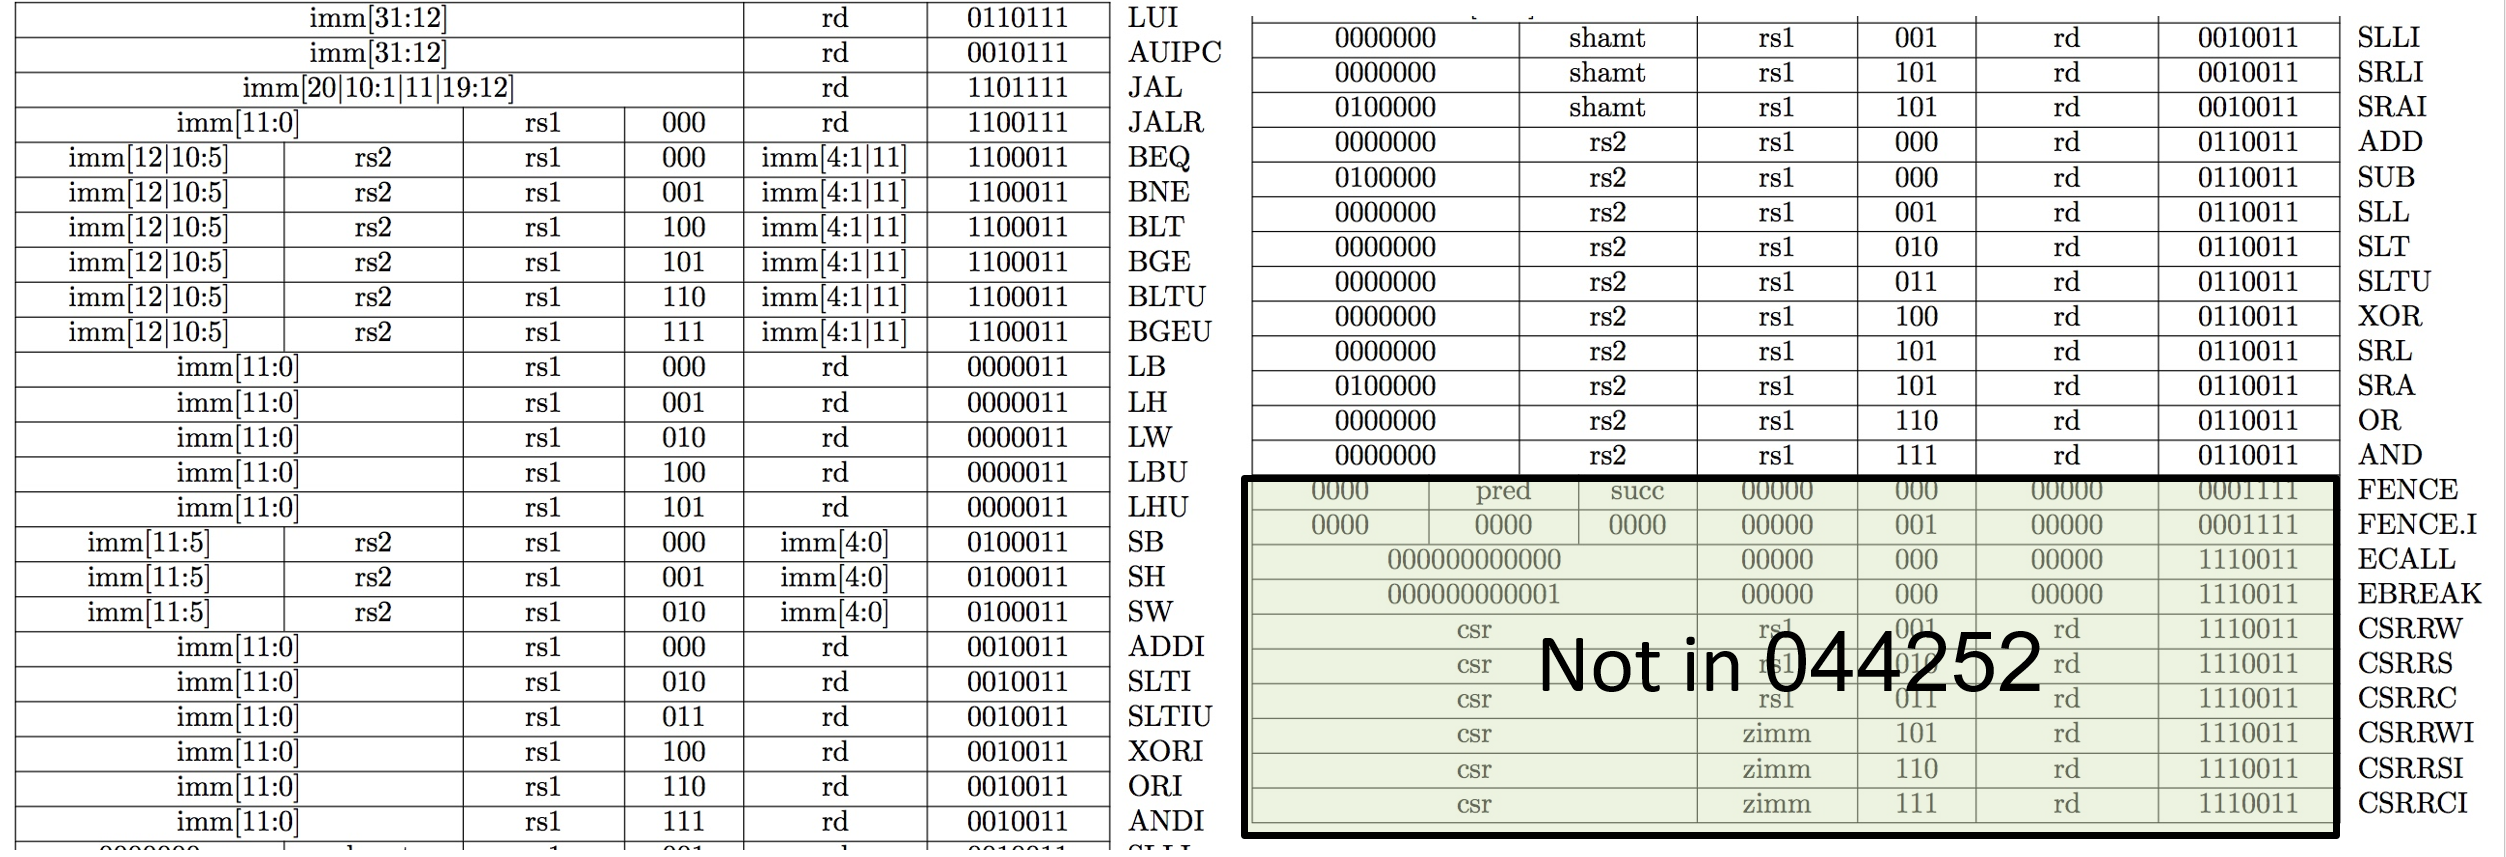
סיכום הפקודות
בונים מחשב
כעת, לאחר שראינו כיצד אנו מבצעים פקודות ומאחסנים דברים בזכרון נדבר על איך זה עובד באמת בחומרה.
המחשב הוא מערכת עקיבה בתכלס, אשר ה--ים שלה הם האורגים(רגיסטרים) שלה(מהם יש אשר אחד מהם קבוע)
בכל עליית שעון, המחשב מבצע פעולה אחת.
⟸ הפלט הנוכחי משנה את הפלט של השלב הבא, וזה למה זו מערכת עקיבה ולא צירופית.
זה נראה כך:
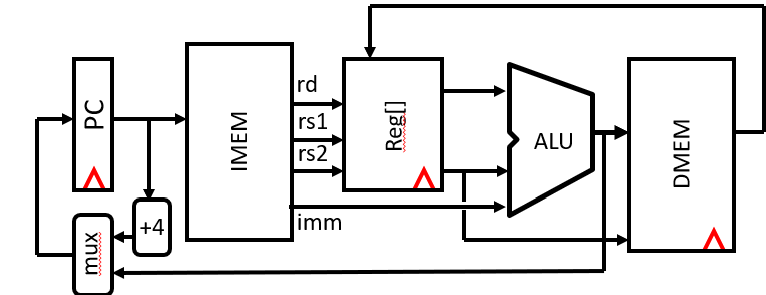
משמאל נוכל לראות את ה- שלנו ובנוסף, יחידה היכולה להוסיף אליו .
התהליך מתחלק ל-5 חלקים:
- קריאת פקודה.
- קריאת הערכים מהזכרון והשמתם לאוגרים
- ביצוע הפעולה(באמצעות ה-)
- כתיבה מחדש לזכרון.
- כתיבה מחדש לאוגרים. (בעצם אנו שומרים את הכל בזכרון ואז כותבים מהזכרון לאוגרים)
זה סרטוט עקרוני וחסרים בו מלא דברים(כגון כניסת בחירה ל-)
מבצעים פקודות
עכשיו, כדי להתחיל באמת לבנות את המחשב שלנו, נבנה פקודה אחת ואת כל החלקים שאנו נדרשים לכך ואז נמשיך לפקודה הבאה והבאה עד שיהיו לנו את כל החוטים והרכיבים הדרושים.
נתחיל מהפקודה add rd, rs1, rs2 אשר משנה בשני דרכים את המערכת:
א. (ביצוע החישוב)
ב. (כדי להתקדם לפקודה הבאה)
מה אנו צריכים בשביל פקודת ?
- אפשרות לקדם את ה- ב-4, בכך, רכיב היודע להוסיף ל- בדיוק 4.
- רכיב קריאה מהזכרון כדי שנוכל לקרוא את הפקודה.
- רגיסטרים אשר יחזיקו את המידע.
- רכיב המבצע פעולת חיבור.
- אפשרות לשמור לרגיסטרים את המידע.
זה יראה כך:
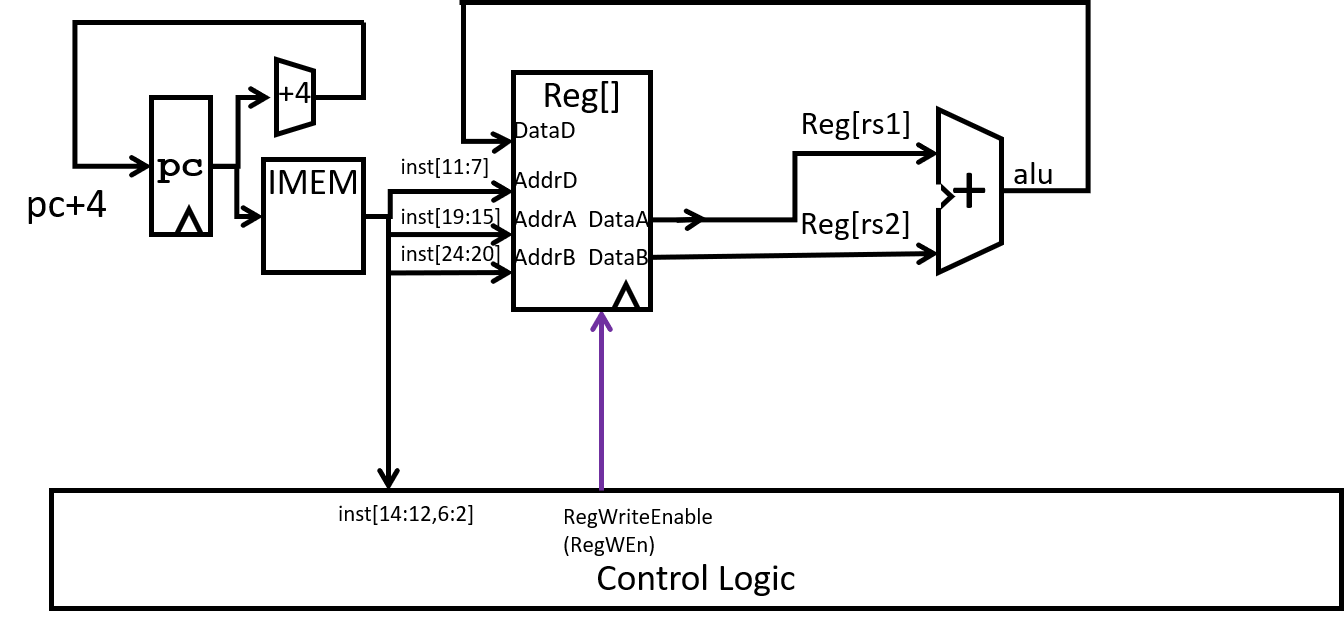
נסתכל כעת על התזמונים של מערכת זו:
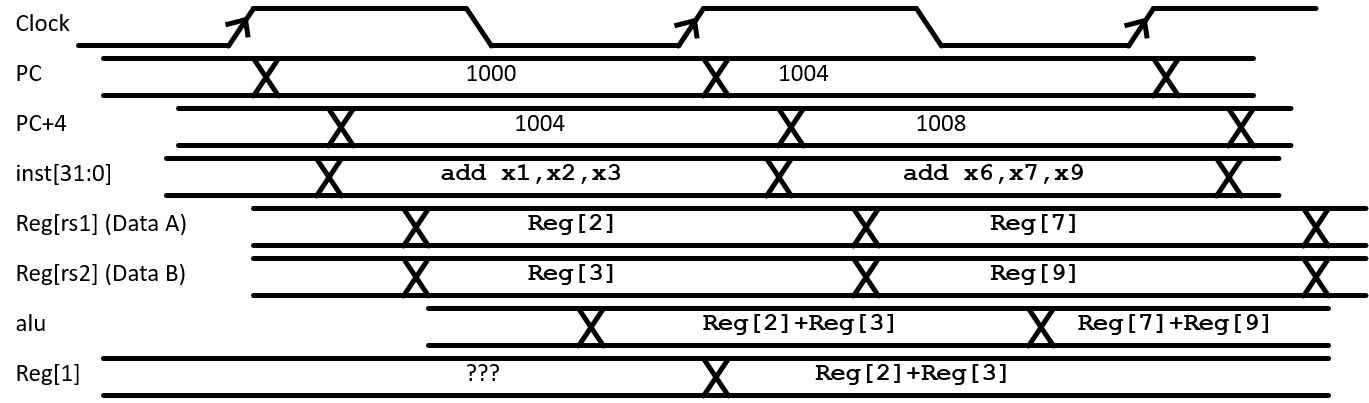
עכשיו נרצה להוסיף פעולת חיסור הנראת כך: sub rd, rs1, rs2.
המימוש שלה כמעט זהה ולכן נוכל להשתמש בכמעט כל הרכיבים באותו הדבר, רק נדרש לרכיב שמבצע חיסור במקום חיבור.
נשים לב כי על פי מה שראינו ברשימת הפקודות, ההבדל בין חיבור לחיסור הוא אשר אם הוא אזי הוא חיסור.
לכן, מפאת קיום ההבדל הזה, נוכל לקחת רכיב אשר יכול לבצע גם חיבור וגם חיסור ולתת לו את כמי שמבדיל בין חיבור לחיסור.
כך, יהיה לנו מחשב שיוכל לעשות גם חיבור וגם חיסור:
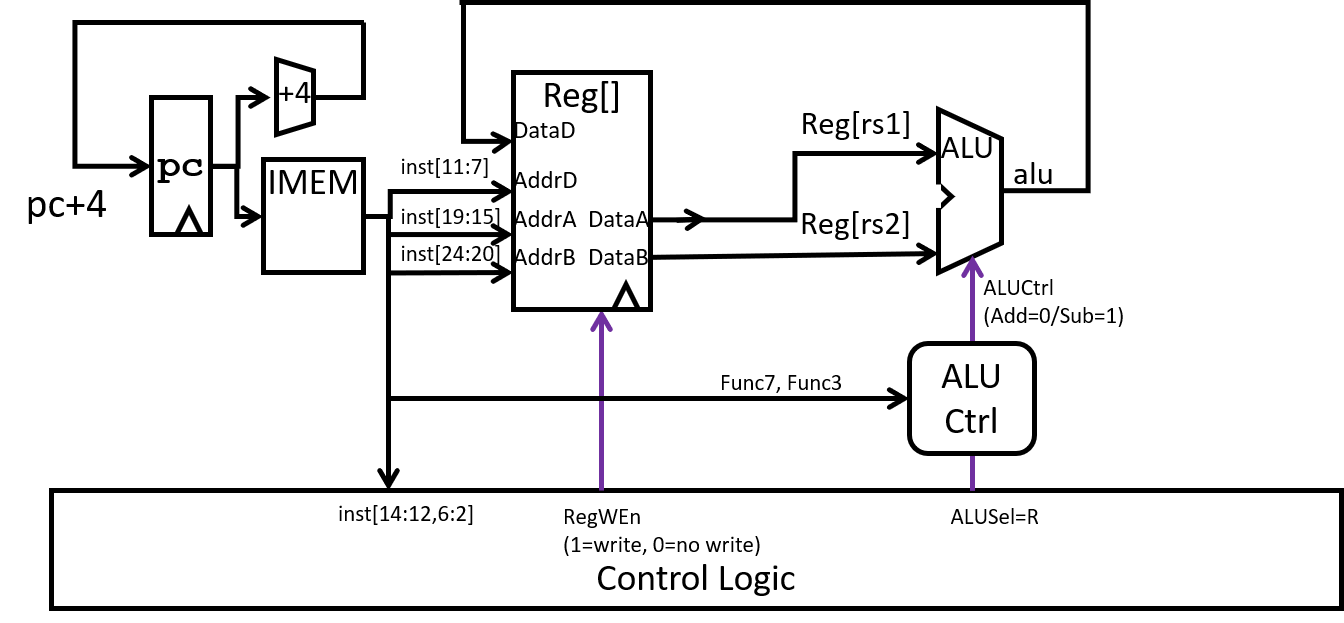
ברגע זה אנו יכולים לבצע את כל הפקודות מהסוג שראינו קודם.
כעת, נעבור להוסיף פקודות מסוג ונתחיל בפקודה addi x15,x1,-50.
מה שחסר לנו במה שבנינו עד כה על מנת לממש סדרה של חיבורים שכן המספר הקבוע יכול להיות בגודל של עד שזה גדול מ- סיביות.
לכן, יהיה לנו יצור בשם אשר יחלק את את המספר, לחצי השני יבצע ואז יאפשר חיבור שלהם כך:
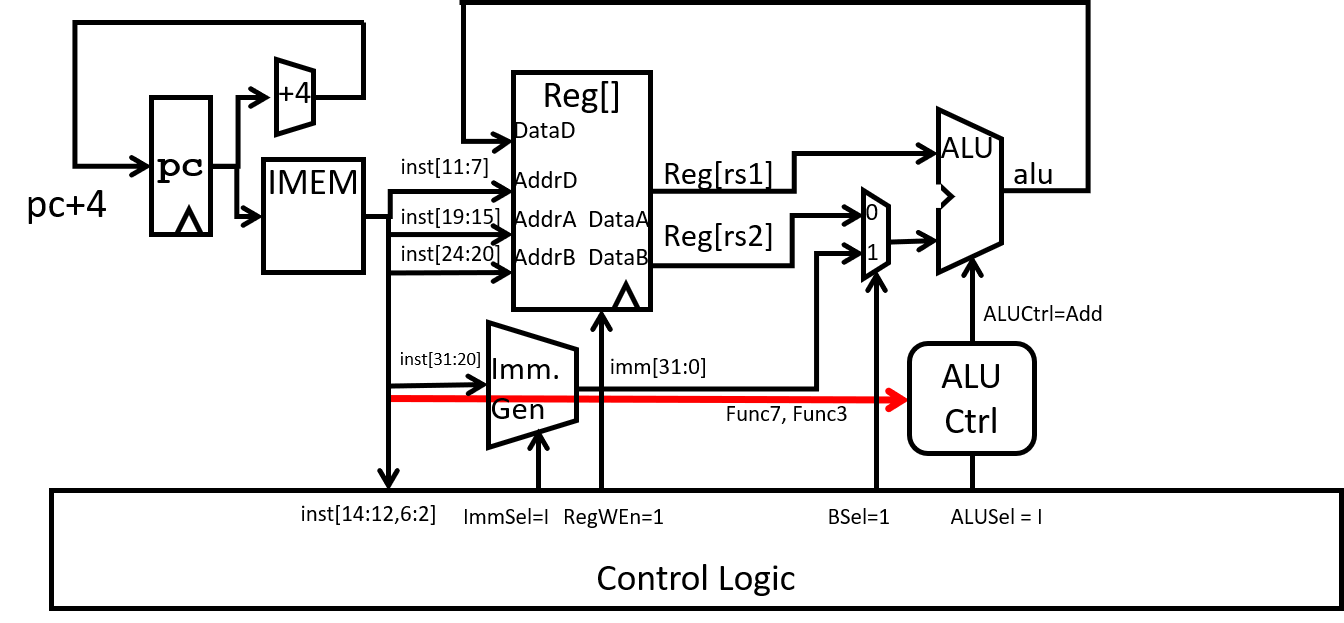
כעת, לאחר שיש לנו יכולת לבצע פקודות מסוג ומסוג , נרצה לממש פקודות הקוראות מהזכרון כדוגמת lw x14, 8(x2).
לפקודות אלו אותו פורמט כמו פקודות ה- אך הן עושות משהו שונה עם התוצאה של החישוב ⟸ היא קוראת מהזכרון ומציבה את המה שנקרא ברגיסטר שהוזן.
אנו צריכים כעת רכיב חדש הכותב לזכרון או קורא ממנו בנקודה ספציפית. זה יראה כך:
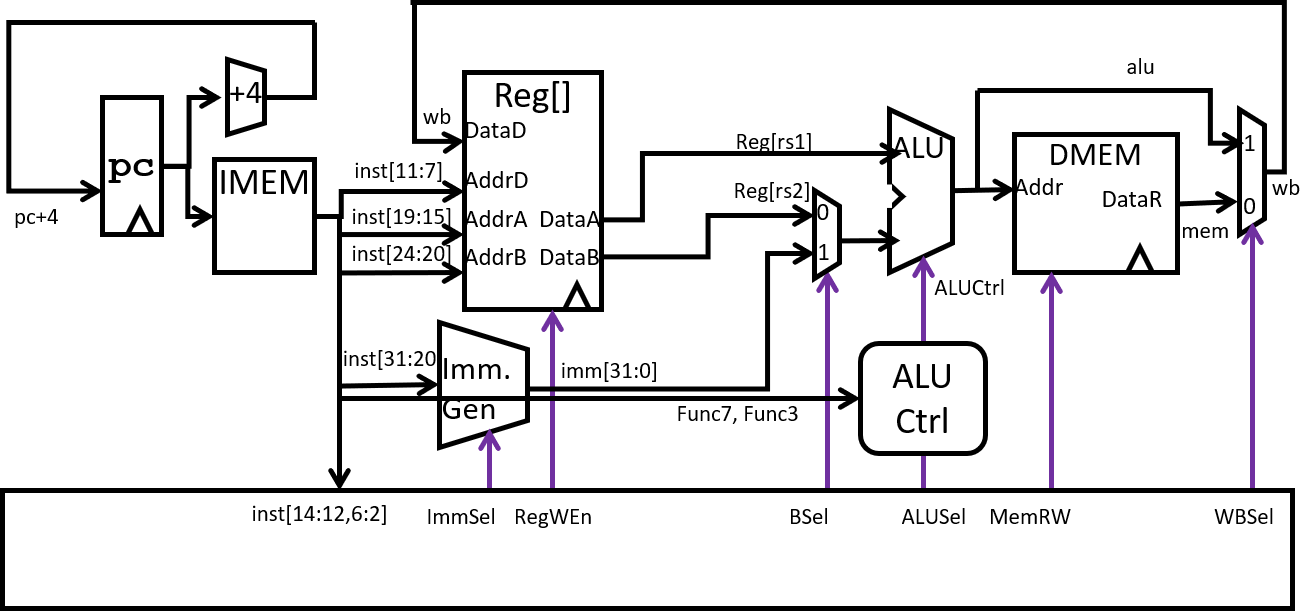
מה שכתוב בשרטוט זה לא באמת כתובת אלא פשוט רגיסטר .
כדי שנוכל לממש גם את נוכל להוסיף מנגנון שמבצע למה שיוצא מהזכרון .
כעת, נתעסק עם פקודות מהסוג אשר הן פקודות אחסון. נתחיל מהפקודה הבסיסית ביותר sw x14, 8(x2).
לשם כך יש לנו כבר את כל מה שאנחנו צריכים כי אנו יכולים לאחסן בזכרון את מה שאנו רוצים עם ה-.
הדבר היחיד ששונה הוא שנדרש דרך להכניס ערך ל- ולא רק כתובת.
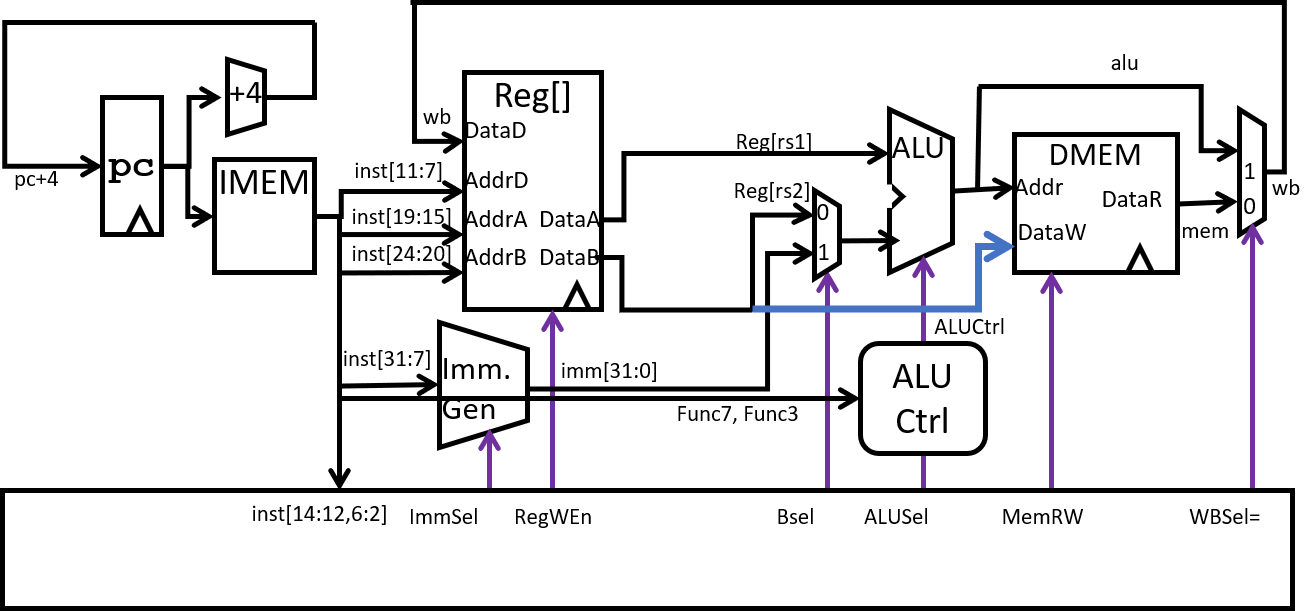
החוט הכחול הוא בדיוק מה שאנו צריכים כדי שגם פקודות האחסון יעבדו.
נשים לב כי ה- עובד שונה על בסיס האם הפקודה היא או ולכן, אנו מכניסים אליו גם חוט אשר אומר לו באיזה מצב אנחנו כדי שיוכל ליצור את הקבוע כמו שצריך.
כעת נעבור לפקודות עינוף, כלומר, פקודות מסוג . פורמט זה כמעט זהה לפורמט עם שני אוגרי מקור וקבוע באורך ביטים.
עכשיו, בנוסף, הקבוע מייצג קפיצה של ביטים(ולא ביט אחד)
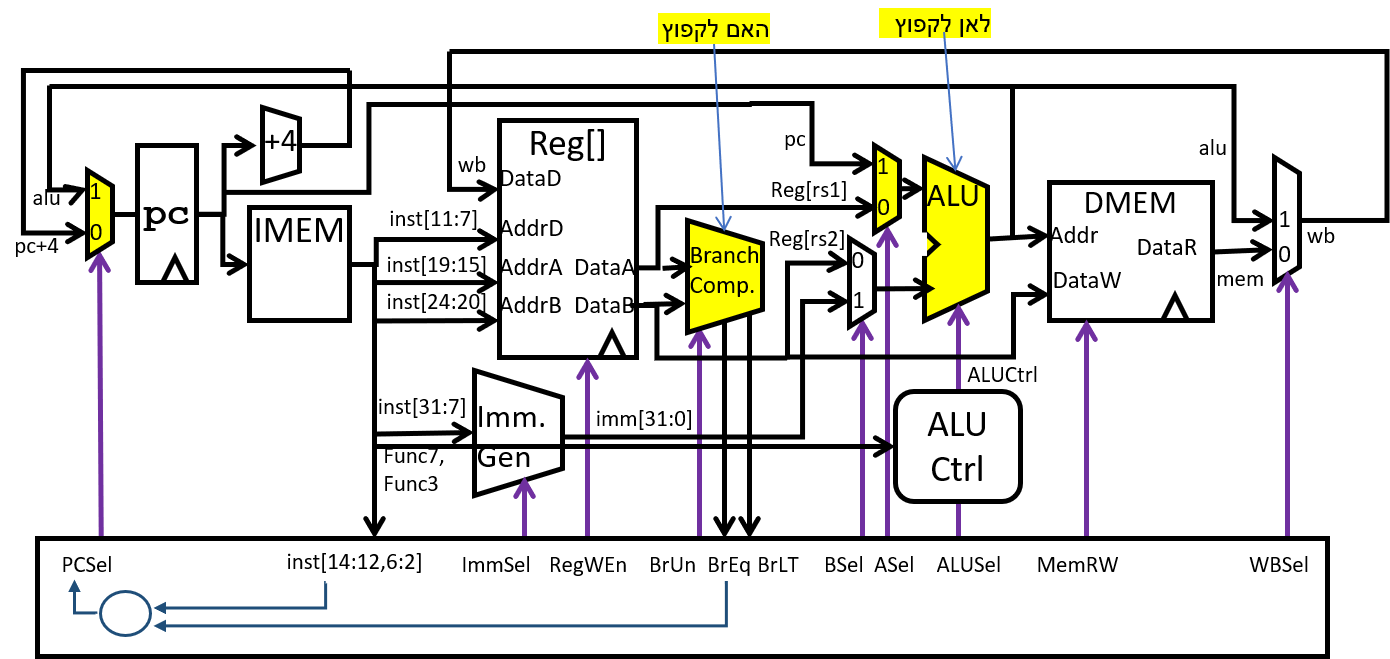
נשים לב כי גם פקודות העינוף דורשות קבוע שהוא קבוע ה- לקפיצה וגם הוא נבנה באופן קצת שונה מהאחרים.
כעת, נממש את jalr rd, rs, immediate אשר כותבת אל , מבצעת .
השימוש פה בקבוע הוא כקבוע רגיל ולא ככפולות של .
לשם כך אנו צריכים דרך לחבר בין לרגיסטרים כדי לרשום את הערך לתוך הרגיסטר. זה יראה כך:
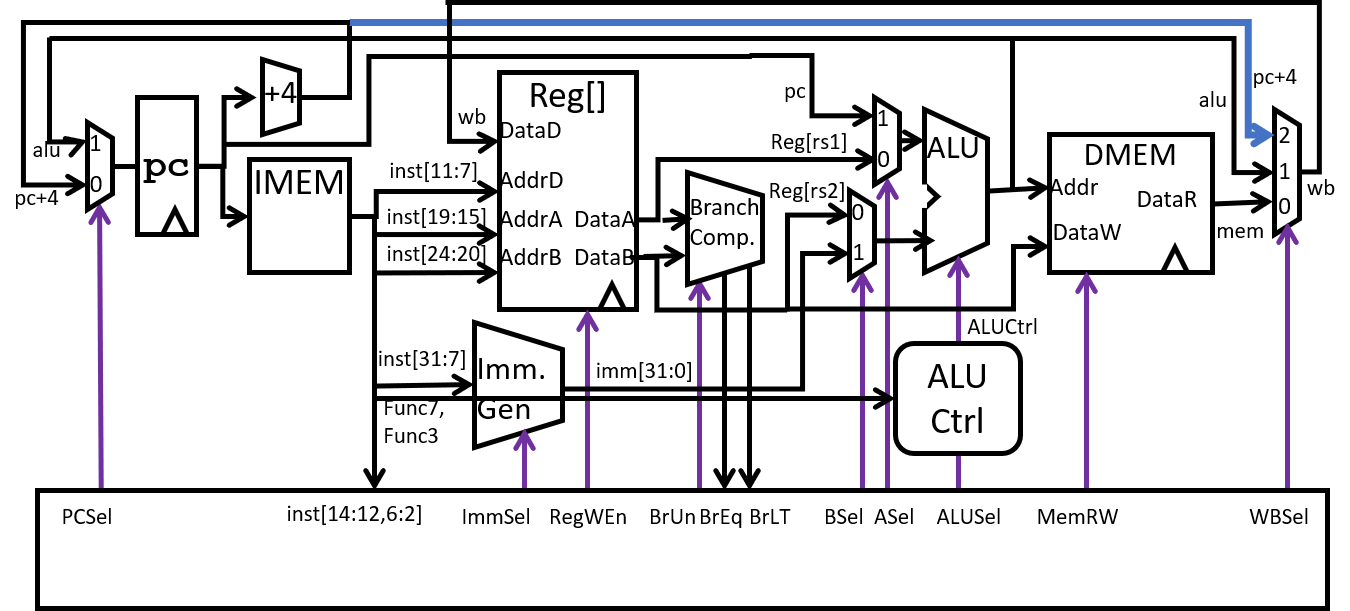
הפקודה עובדת באופן מעט שונה שכן היא שומרת באופן אוטומטי את הכתובת לרגיסטר ולא לרגיסטר לבחירתינו. לשם כך, אנו נוכל להשתמש באותו היצור.
הפקודות הבאות הן מסוג אשר מאפשרות לנו להסתכל על הסיביות ה- של רגיסטר.
לפקודות אלו לא צריך להוסיף דברים במעגל שיצרנו.
שולטים בלוגיקה
נרצה כעת לראות איך מממשים את הבקר הזה שראינו שהיה קופסה שחורה עד כה.
לבקר יש טבלת אמת יחסית גדולה:
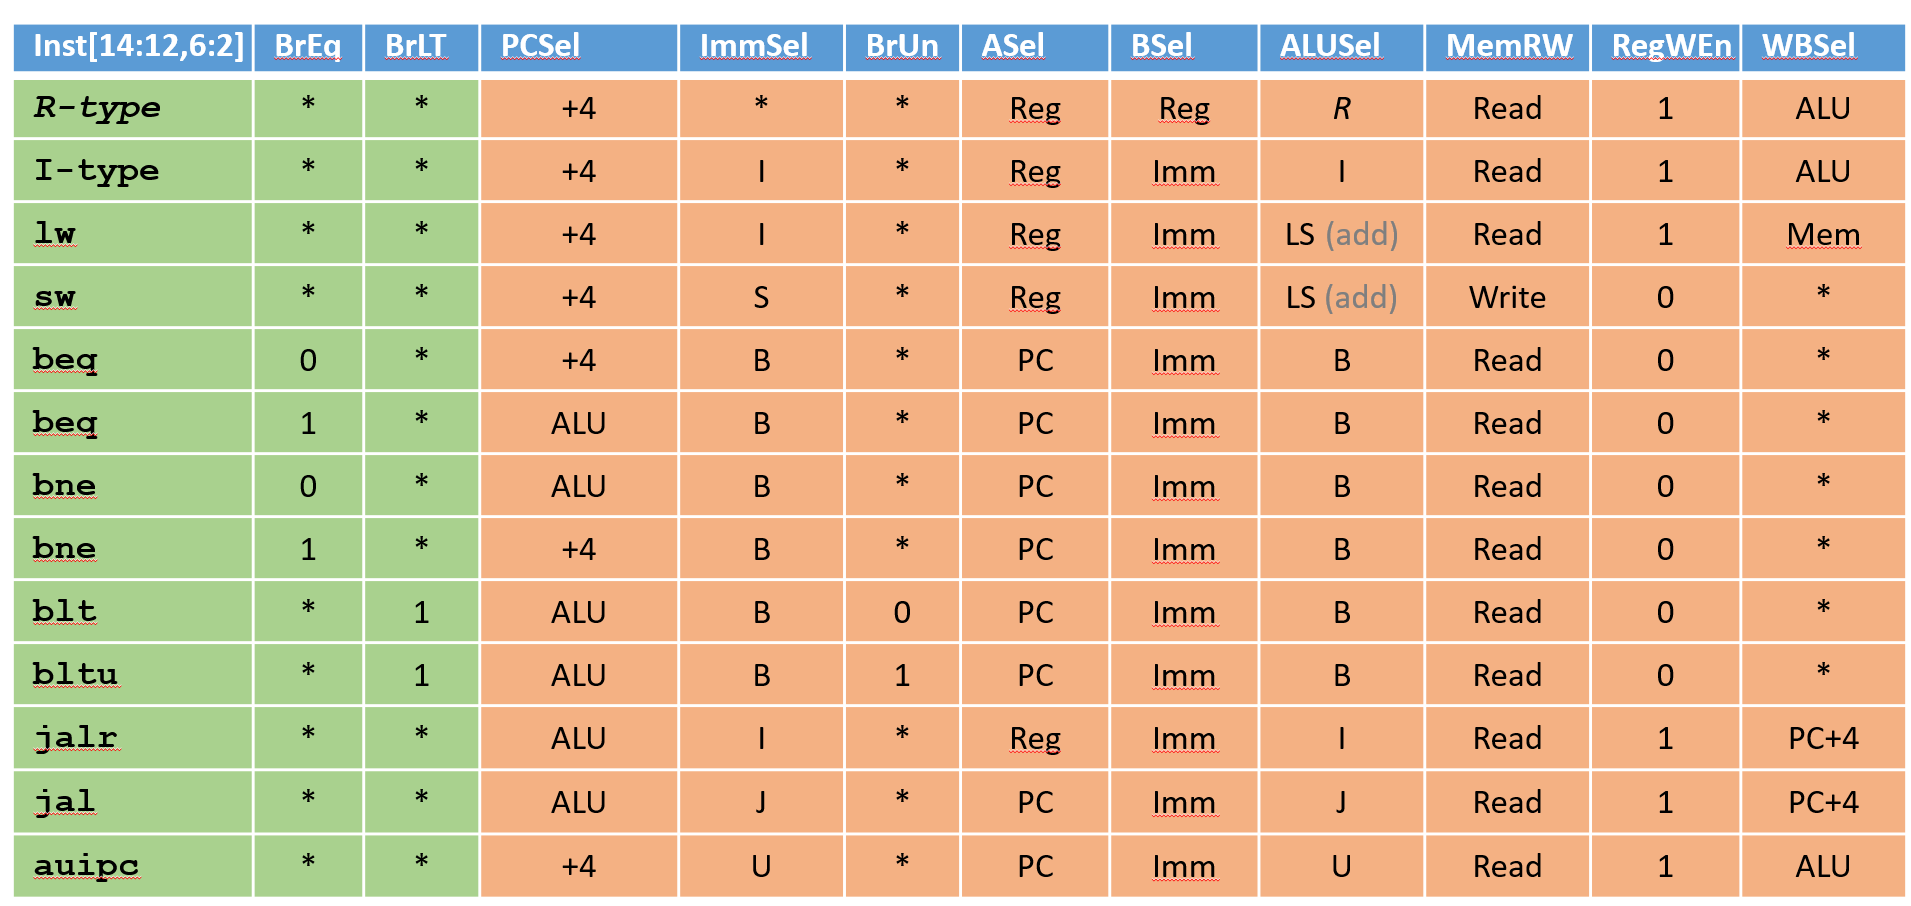
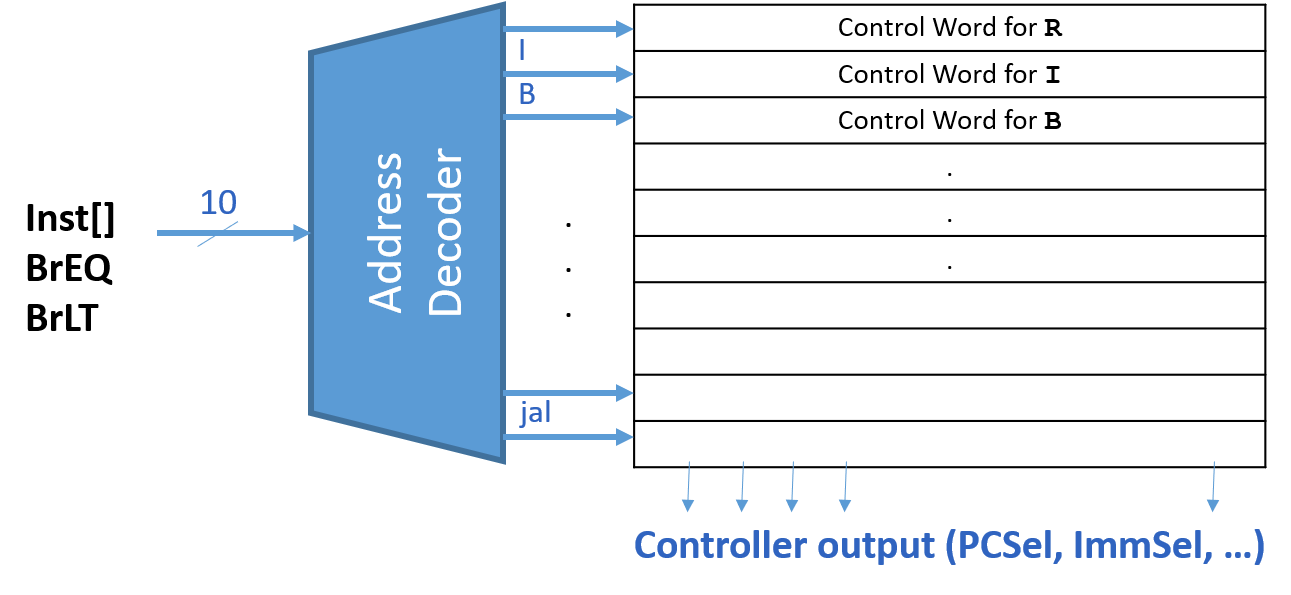
נקח (זכרון לקריאה בלבד) ובאמצעות בחירה של מיקום הקריאה הנכון, נוציא את הערך הנכון לכל חוט.
כדי לממש אותו אנו נשתמש במפענח בתצורה כזו:
תזמון פעולות
כעת, לאחר שיש לנו בקר ומבצע פעולות שבנינו ממקודם, נוכל להסתכל על כמה זמן לוקח התהליך הזה של ביצוע פקודה.
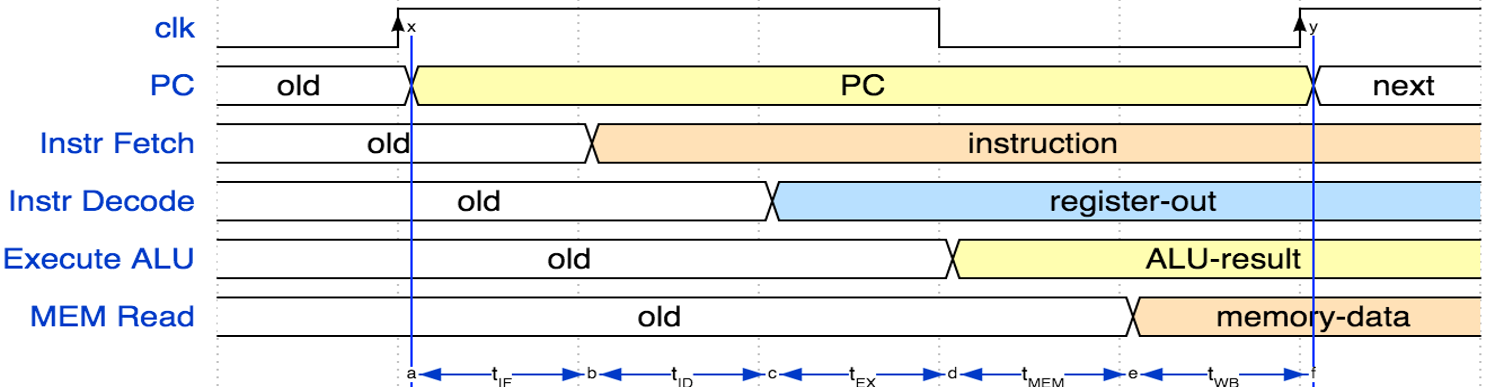
נסתכל על ערכים רגילים של זמנים:
נשים לב כי ולכן המעבד שלנו יכול לבצע מלאאא פקודות בשנייה אחת.
נשים לב כי למרות שיש פקודות אשר לא דורשות את כל הרכיבים, הפקודות שלוקחות הכי הרבה זמן כן דורשות את כולם ולכן, השעון שלנו יעבוד על זמן מחזור שיתאים לפקודה הארוכה ביותר שכן אנו לא יכולים לשנות מחזור שעון על בסיס הפקודה.
מחשב
אנו ראינו שפקודות שונות דורשות זמן שונה, ואנו רוצים כעת למצוא דרך לבצע את אותה התוכנה באופן מהיר יותר. כדי לעשות זאת נרצה לשנות את איך שהשעון שלנו עובד ולהתאים אותו לכל פקודה.
אנו נחלק את החישוב לכמה שלבים, נבצע שלב אחד בכל מחזור שעון אחד וכך נוכל ללכת מהר יותר שכן לכל פקודה יש מספר מחזורים שונה.
אנו בשביל זה נדרש לרגיסטרים חדשים אשר ישמרו את המידע בין כל שלב לשלב.
עד כה ראינו אוגרים אשר מחזיקים מידע לזמן לא ידוע, כעת, עבור ה- שלנו, נשתמש באוגרים אשר מחזיקים מידע למשך ביצוע של פקודה אחת. לא ניתן לגשת לאוגרים אלו מהמחשב עצמו, והם רק משמשים את המערכת עצמה.
כעת, נשים את האוגרים האלו בכל אחד הקווים הכחולים:
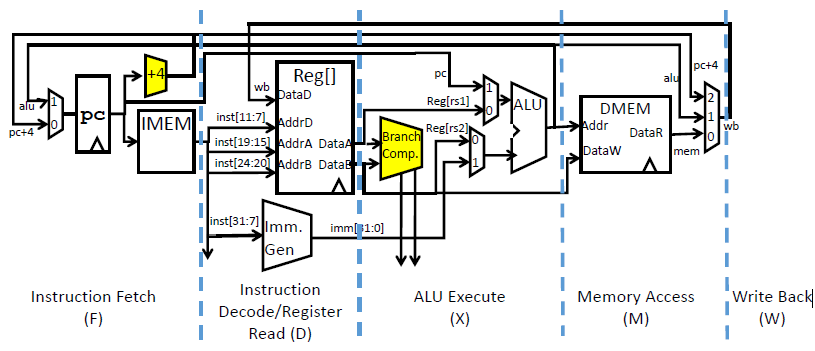
בעצם חילקנו את המעבד לשלבים.
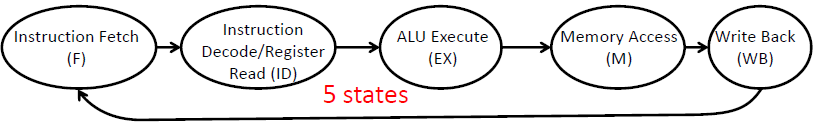
כך נראת מכונת המצבים של מעבד זה.
נשים לב כי כעת, מכיוון שאנו שומרים את התוצאות, אנו יכולים לוותר על ה- שכן נוכל במחזור שעון אחד לבדוק האם אנחנו רוצים לקפוץ, ואז עם כן, נוכל לחשב את מיקום הקפיצה במחזור השעון הבא.
באותו האופן עם ה- שלנו.
לכן, המחשב שלנו יראה כך:
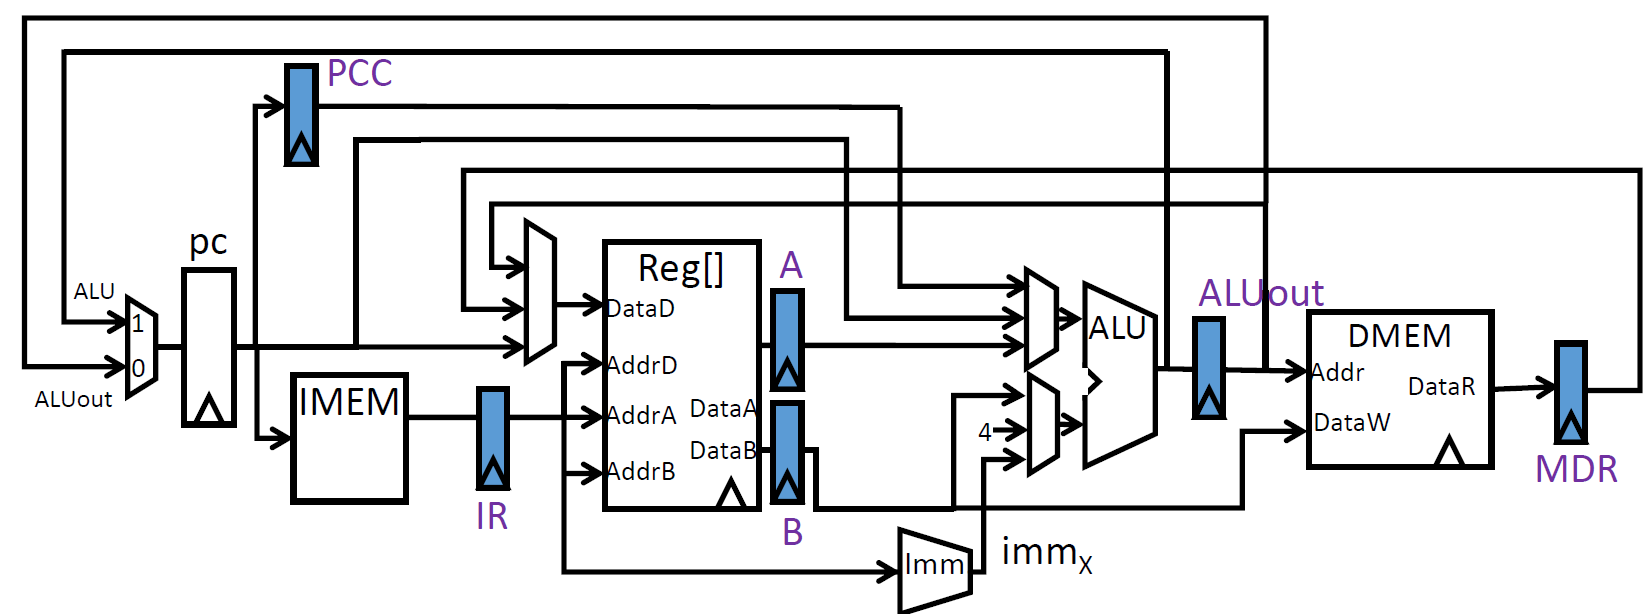
אנו שומרים את שהוא הערך הנוכחי של מכיוון שיש פקודות שהוא נדרש בהן לחישוב, נניח וכדומה.
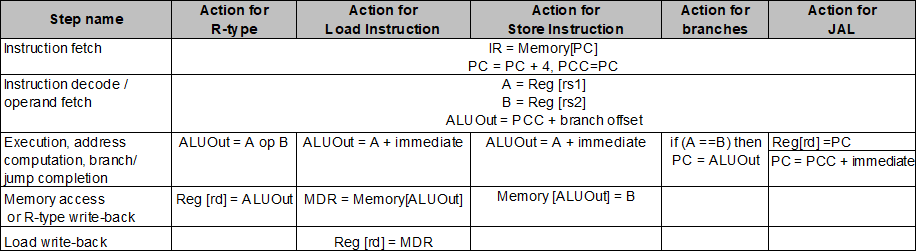
כל פקודה מבוצעת מעט שונה וכל שלב שלה מעט שונה, אבל באופן כללי:
כעת נרצה לבנות את הבקר ולשם כך תהיה לנו מכונת מצבים:
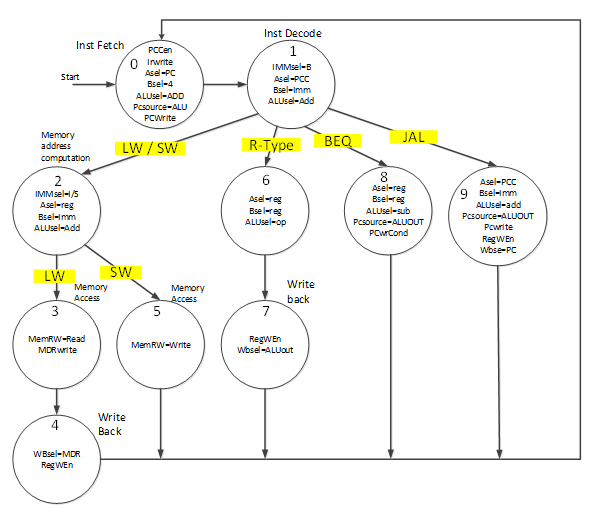
ביצועים
ב- כל פקודה דורשת מספר מחזורים שונה:
- פקודות טעינה מחזורים.
- פקודת אחסון 4 מחזורים.
- פקודת חשבון 4 מחזורים.
- פקודת עינוף 3 מחזורים.
- פקודת קפיצה 3 מחזורים.
יש לנו אך בעיה, קשה בתכלס לחלק באופן מאוזן את מחזורי השעון ובנוסף, הרגיסטרים עצמם גם כן מוסיפים זמן ולכן, באופן פרקטי, זמן ביצוע פקודה הוא זהה.
אז למה ה- יותר טוב? אם נוסיף פקודה ארוכה מאוד מאוד מאוד, אז זמן המחזור לא ישתנה וזמן ביצוע התוכנה לא יוארך באופן דרסטי. זאת בניגוד ל- אשר בו, אם נוסיף פקודה מאוד מאוד ארוכה, זמן הביצוע של כל פקודה יהיה מאוד מאוד ארוך.
מממשים את מכונת המצבים
[מה אפילו קרה פה????]
חריגות ופסיקות()
חריגות הן אירועים הגורמים להפסקת ביצוע רצף הפקודות ולקפיצה לתוכנית אחרת.
חריגות נוצרות ע"י אחד משלושה גורמים:
- התוכנית עצמה.
- בעיות בביצוע התוכנית.
- גורם מחוץ למעבד.
המושגים הללו אינה אוניברסליים ובכל מחשב נהוגות הגדרות מעט שונות.
כמו בקריאה לשגרה, גם בחריגה מבוצעת קפיצה, אלא שהיעד נמצא במערכת ההפעלה.
המעבר לתוכנית אחרת מחייב אחסון יותר פרמטרים מאשר בקריאה לשגרה, שכן אנו נדרשים לגבות את כל האוגרים.
כאשר מתרחשת חריגה, מערכת ההפעלה יכולה לעשות כל מיני דברים שונים ולאחר שהיא עשתה אותם, היא תחזור לתוכנית המקורית באחת מהדרכים הבאות:
- לחדש מיידית את ביצוע התוכנית בפקודה בה נגרמה החריגה. (שחזור כל הרגיסטרים!)
- להעביר את התוכנית לסוף תור תוכניות הממתינות לחידוש הביצוע.
- להפסיק את ביצוע התוכנית ולעבור לתוכנית אחרת.
[להשלים מהמצגת]
עד כה אנו ראינו מעבד ומעבד .
אנו חילקנו את ביצוע הפעולה ל- שלבים אשר ביחד לוקח להם זמן כלשהו.
נרצה כעת לייעל שוב את המעבד שלנו לאחת מהצורות היעילות ביותר שאפשר - הצורה היעילה ביותר שנלמד בקורס.
נשים אוגרים אמיתיים ולא זמניים בין חלק לחלק ואז, כאשר פקודה תסיים שלב אחד, נעביר אותה לשלב הבא ונכניס לשלב הנ"ל את הפקודה הבאה כדי לשפר את ה- :)
ה- שנקבל הוא פי יותר טוב מה- או ה-.
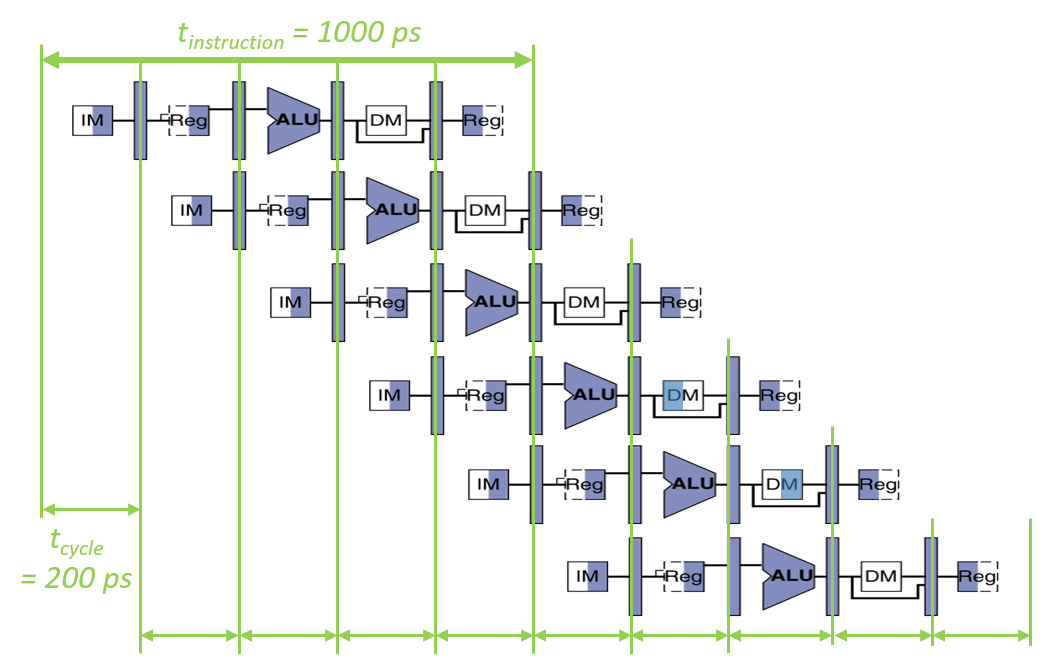
על מנת לבנות את המחשב החדש הזה שלנו, נתחיל ממודל ה- שכן כל דבר צריך להיות מבוצע פעם אחת שכן המידע תמיד זורם.
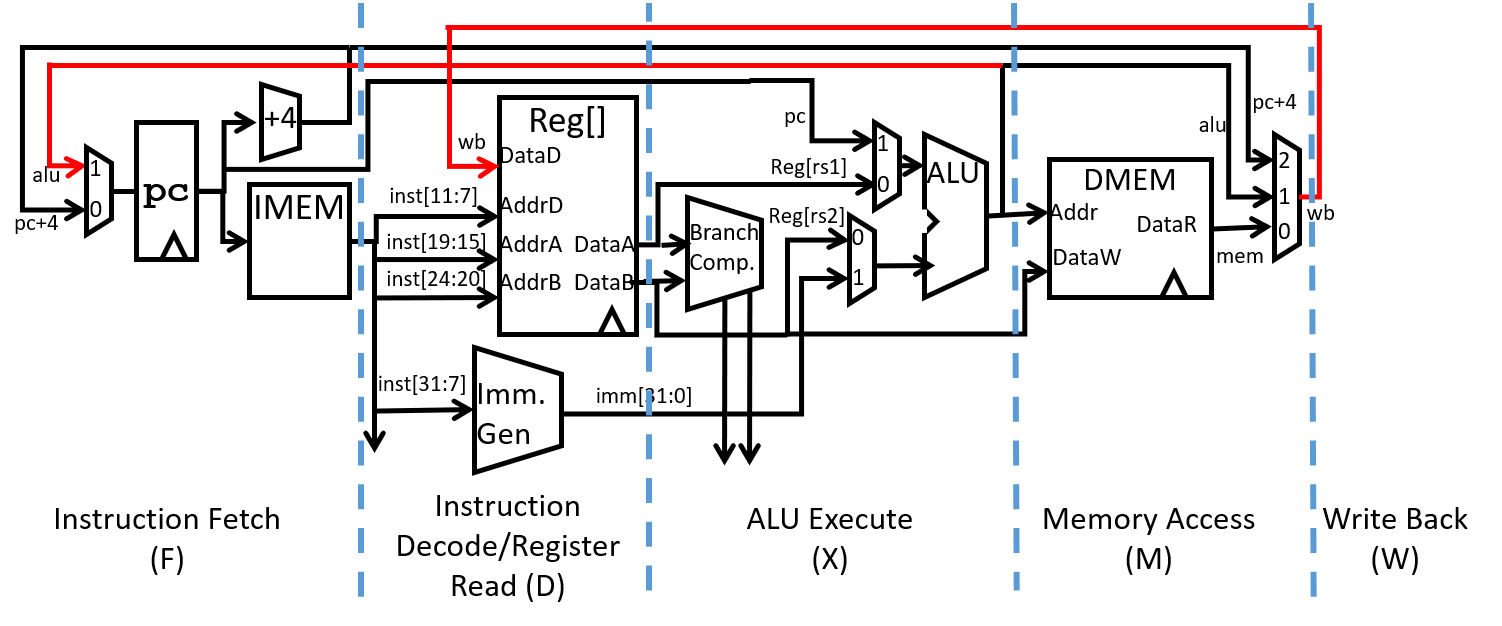
נשים לב כי חסרים לנו כמה דברים על מנת לבצע את הצנרור שאנו כה רוצים - אנו רוצים לשמור את כל הפרמטרים של הפקודה ונראה איך עושים זאת כעת:
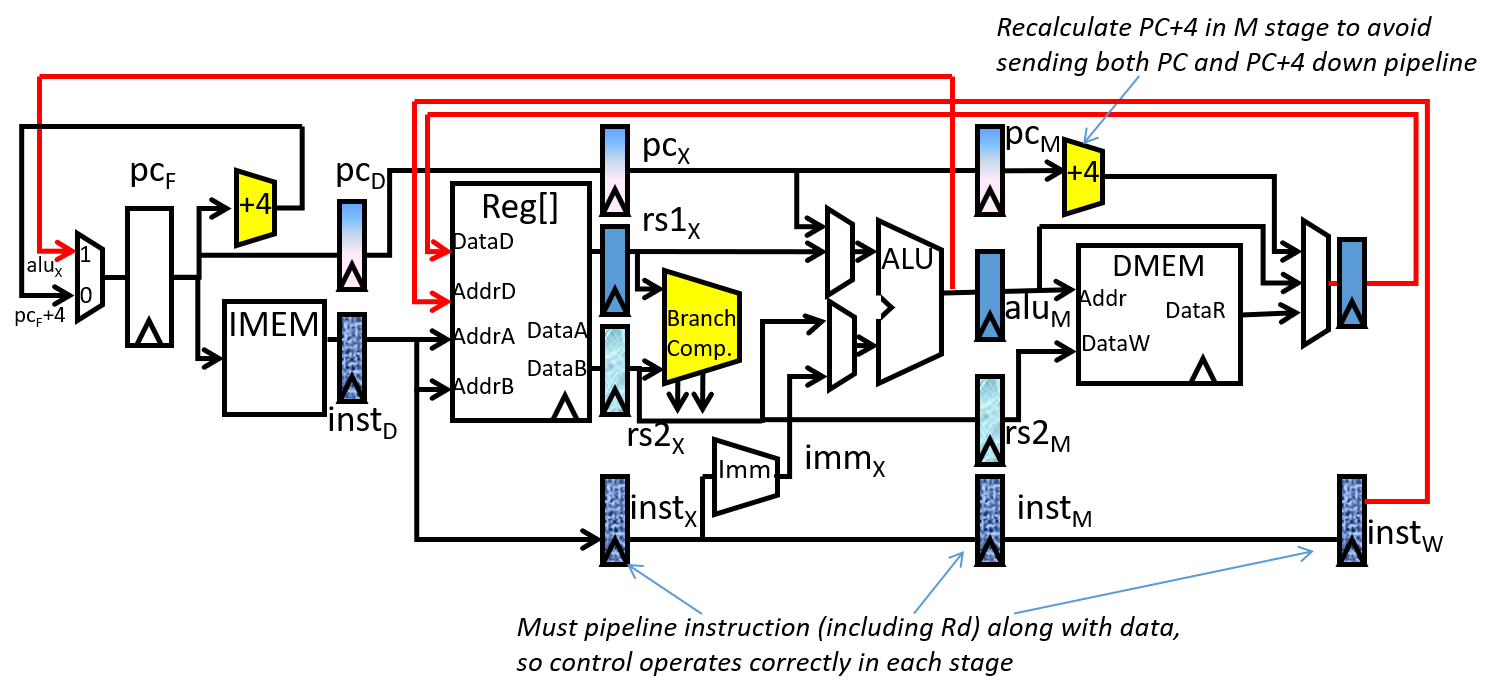
כרגע לא איכפת לנו מכמות החומרה, אנו פשוט רוצים מחשב מהיר.
שליטה ב-
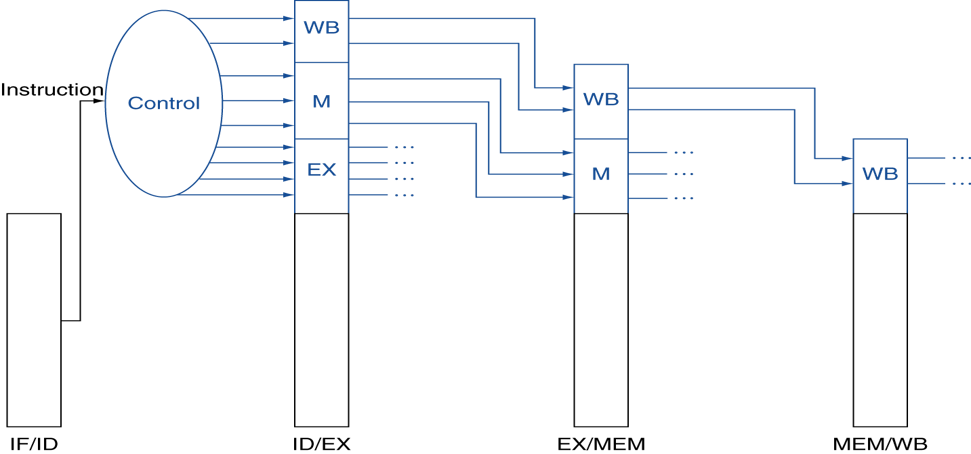
בארכיטקטורת הצנרור (), סיגנלי הבקרה מיוצרים בשלב הפענוח (), בדיוק כמו במעבד ה-
אך מכיוון שכל פקודה מתקדמת שלב אחד בכל מחזור שעון, אנו לא יכולים להשתמש בכל סיגנלי הבקרה מיד. הפתרון הוא להעביר את סיגנלי הבקרה הלאה יחד עם הפקודה עצמה דרך אוגרי ה-.
בכל שלב, המעבד עושה שימוש רק בסיגנלים הרלוונטיים לאותו שלב, ומעביר את שאר הסיגנלים לשלבים הבאים
סכנות בצנרור()
השימוש בצ